过去被当作“临时缓存”的 KV Cache,开始成为需要被长期保存、调度和复用的重要数据资产。
模型上下文越来越长,Agent 任务持续时间越来越久,AI Coding 等场景甚至需要跨天、跨周保留项目上下文,原本依赖显存、内存和本地 SSD 的三级缓存体系,容量、成本和寿命都开始触碰瓶颈。业内诸多厂商开始在这三层之外增加一层面向大规模推理的专业存储,其中也包括华为。
近日,华为正式发布了 OceanStor M900 AI 记忆存储。OceanStor M900 M900 并不是简单给 AI 服务器“再加一块盘”,而是希望把 KV Cache 从计算节点内的临时资源,变成可以在集群范围内共享、保存和复用的“记忆”。
这背后也是华为对当前 AI 产业阶段的判断:当模型能力和算力逐渐趋同时,决定企业 AI 落地效率的变量逐渐成为有没有高质量的数据、有没有足够的上下文记忆,以及能不能用更低成本把这些记忆反复利用起来。
KV Cache 成为新基础设施层
传统大模型对话中,KV Cache 往往只是一个短生命周期的临时数据。用户结束会话后,这部分缓存很快就可以释放。但 Agent 和 AI Coding 改变了这一逻辑。
普通问答通常以短时、单次会话为主,上下文时效性强,因此 KV Cache 可能只需要保留数小时,一旦对话结束就可以清除。但在 AI Coding 场景中,代码仓库、工程框架、此前生成结果以及项目上下文会被持续复用,KV Cache 可能需要保留数天甚至数周。
也就是说,不同应用开始出现完全不同的“记忆周期”。企业需要根据具体业务定义哪些 KV 值得保存、保存多久、什么时候淘汰,而不是简单采用一套固定策略。
这也是华为将 OceanStor M900 直接称为“AI 记忆存储”的原因。华为分布式存储领域总裁杨文道表示,“M”代表 Memory,其核心目标就是把原本局限于显存和内存中的上下文记忆扩展出去,让更多 Token 对应的 KV 可以长期保存并重复命中。
华为内部测试和客户 POC 显示,通过专业 KV Cache 存储,可以让 Token 命中率提升约一倍,同时降低首 Token 时延(TTFT)。对企业而言,这不仅影响用户体验,也直接关系推理成本:如果历史上下文可以命中缓存,就不需要每次重新执行完整的 Prefill。
目前,比较常见的推理缓存结构是:L1 位于显存,L2 位于内存,L3 位于本地 SSD。显存和内存访问时延在纳秒级,但容量有限、成本较高;本地 SSD 容量更大,但访问时延已经进入毫秒级。随着长上下文和大规模 Agent 任务增加,仅靠这三层已经越来越难容纳不断膨胀的 KV Cache。
杨文道表示,OceanStor M900 AI 记忆存储是聚焦 L3.5 层,L3.5 并不是华为独创的概念,而是 AI 推理规模化之后,全行业面对容量和成本瓶颈自然演进出来的方向。华为选择在这一层推出专门产品,是因为传统三级缓存体系已经不足以承载未来的 KV 规模。
按照华为与客户的实际测算,如果真正按照生产要求保存大量上下文,最终需要的已经不是 TB 级,而是 PB 级存储。OceanStor M900 将超节点中的 KV Cache 从显存、内存进一步扩展到 SSD,单集群可提供 64PB 容量,单 NPU 可使用的 KV Cache 容量也从 GB 级提升到 TB 级。
从华为的判断来看,专业的 KV 上下文记忆存储并不是简单增加一个产品类别,而是可能成为大规模推理基础设施中新的固定层级。
从显存下沉到 SSD,真正难的是做 KV 调度
把 KV Cache 从显存和内存下沉到 SSD,看起来解决了容量和成本,但同时引入了一个新的问题:时延。
显存和内存的访问时延是纳秒级,而 SSD 已经进入毫秒级。如果模型每次需要 Token 时都临时从 SSD 读取,理论上完全可能因为数据访问变慢,抵消缓存复用带来的收益。因此,真正决定 L3.5 能否成立的是如何调度 KV。
杨文道向 InfoQ 表示,华为在内部测试和客户 POC 中也遇到了这一问题。目前行业比较常用 Mooncake 推理框架,华为在这一框架基础上继续解决 KV 调度和预取问题。系统需要提前判断模型接下来可能使用哪些 KV,并根据显存、内存和 SSD 不同介质的性能进行分层预取,在真正需要访问时尽量让数据已经进入更高速的上一层。
同时,传统使用分布式文件系统或者并行文件系统保存 KV,往往需要先把 KV 转换成文件,再通过目录找到文件、读取文件,最后重新解析成 KV 交给模型。这中间经历了多次格式和协议转换。
OceanStor M900 AI 记忆存储则希望把这一过程缩短成“一跳直通”。KV 不再需要先转换成传统文件对象,而是直接按照 KV 语义进行访问,再通过昇腾超节点中的高速通信网络完成数据交换。其本质是让 NPU 尽可能把算力用于推理本身,而不是消耗资源进行数据转换和搬运。
当前,OceanStor M900 采用“三芯合一”架构,将网络、CPU 和盘控能力整合,并与灵衢网络及昇腾超节点协同。华为希望最终把计算、存储和网络视为一个整体,而不是过去意义上的“计算节点外挂存储”。
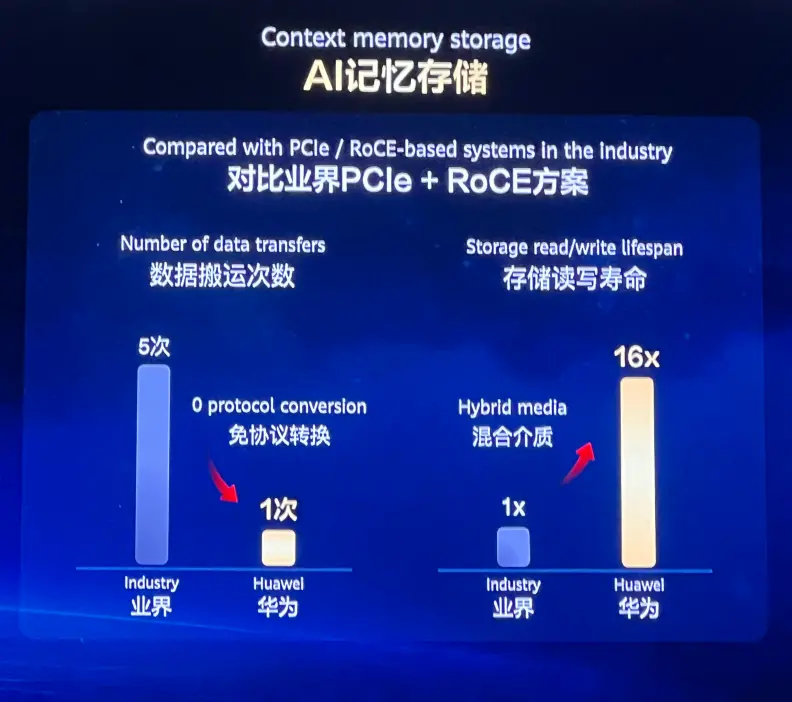
披露的数据显示,传统 PCIe+RoCE 架构中,GPU 或 NPU 访问 SSD 池可能需要进行 5 次数据搬运,而 OceanStor M900 可以减少到 1 次,I/O 时延和首 Token 时延降低超过 50%。其访问时延约为 10−15 微秒,访问带宽可以达到 40GB/s。
不过,这也带来了另一个关键问题:OceanStor M900 是否只能运行在华为自己的生态中?
杨文道对此解释称,OceanStor M900 当前定位配套昇腾超节点,通过 UB 协议完成超节点内部的数据交换,对上层应用而言并不需要感知这些底层通信方式。对于非昇腾、非超节点或者异构算力环境,华为已经提供 OceanStor M800,通过标准网络和硬件适配不同算力平台。
OceanStor M900 和 OceanStor M800 两款产品并非“高低配”关系,而是华为面向不同基础设施的不同产品形态。OceanStor M800 先于 OceanStor M900 上市,已经与多家客户进行测试;OceanStor M900 则进一步面向昇腾超节点,将计算、存储和网络做更深层次的一体化协同。
虽然主要面向超节点,但 OceanStor M900 不只在 10 万卡规模才有价值。杨文道表示,其价值会随着集群规模扩大而进一步放大。理论上,只要企业进入大规模 AI 推理,并开始遇到 KV Cache 容量、成本和共享问题,就可能产生专业记忆存储需求。
寿命和缓存淘汰成为新的工程难题
专业记忆存储另一个容易被忽略的问题,是 SSD 寿命。
普通企业级 SSD 通常使用 DWPD(Drive Writes Per Day,每日全盘写入次数)衡量耐久度,一般在每天 1—1.5 次左右。对于传统存储业务,这一水平基本能够满足使用周期要求,但 KV Cache 的写入模式完全不同。
如果大量 Agent 和长上下文任务不断创建、更新和淘汰 KV,SSD 可能需要极高频率地重复写入。如果继续沿用传统模式,就只能通过不断增加 SSD 数量摊薄写入压力,最终成本会迅速上升。
杨文道举例,如果 SSD 每天只能完整写入一次,那么为了保存大量 KV,就需要非常大的物理容量;但如果 DWPD 提升到 24,相当于允许一个小时完成一次全盘级写入,那么大量只需要保存一小时的 KV 就可以快速写入、淘汰,再复用同一批介质。
因此,OceanStor M900 的关键价值之一就是提升介质寿命。华为披露,通过介质、芯片和控制软件共同优化,在保持高频读写性能的同时避免 SSD 快速损耗,据实测,可将相关寿命能力提升接近 16 倍。
这一点实际上也是决定“SSD 做 AI 记忆”在商业上是否成立的关键。如果寿命问题无法解决,那么 KV Cache 只能继续依赖昂贵的内存或者通过大量堆盘获得容量,专业记忆存储的成本优势就会被削弱。
另一方面,并不是所有 KV 都需要永久保存。华为认为,真正合理的方式是根据业务动态设置缓存生命周期。
普通对话可能只保留几个小时,AI Coding 可以保留数天乃至数周;不同模型、不同项目也会采用不同策略。企业通常知道哪些业务上下文值得长期保留,因此系统可以根据业务规则动态淘汰。
可以看出,未来的 AI 记忆管理,本质上可能越来越类似传统计算机的多级缓存:不是简单追求“存得越多越好”,而是在命中率、容量、成本、寿命和访问时延之间寻找动态平衡。
华为同时把 KV Cache 进一步放进一个更大的“AI 数据平台”体系中。华为数据存储产品线副总裁吴俊杰介绍道,华为目前定义的 AI 数据平台包含四个核心能力:KV Cache 库、知识库和记忆库,并通过 UCM(Unified Cache Manager,统一缓存管理器)进行管理。
其中,KV Cache 库解决的是推理过程中上下文重复计算的问题;知识库负责把传统文件转化为更容易被 AI 检索和理解的知识,提高专业场景的回答准确率;记忆库则进一步保存 Agent 长期执行任务过程中形成的历史经验、过去回答和任务结果,让系统逐渐积累“经验”。三者分别对应“短期上下文”“专业知识”和“长期经验”,共同构成企业 AI 的新数据层。
相比 OceanStor M900 主要面向大规模数据中心和超节点推理,AI 数据平台则更加面向企业本地化部署,希望成为企业未来运行 AI 应用的一套通用数据底座。
不把“记忆层”做成封闭市场
“华为肯定不想做孤勇者。”杨文道说道。
当前,华为一方面在昇腾超节点中继续利用垂直整合优势,另一方面尽量把上层 KV 调度和推理能力接入主流开源生态。
Mooncake 就是重点之一。杨文道表示,华为目前已经与 Mooncake 团队进行合作,并计划未来把部分推理相关代码贡献到 Mooncake 社区。华为希望专业记忆存储最终成为整个行业的基础能力,而不是一家厂商独占的封闭技术。
在其看来,L3.5 市场目前仍处于早期阶段,首先需要解决的是“这个市场能不能真正成立”的行业问题,而非提前通过封闭生态锁住客户。只有推理框架、模型、算力厂商和存储厂商共同参与,KV Cache 外置和专业记忆存储才能真正进入规模化应用。
面对与其他存储厂商的竞争,华为认为,AI 记忆存储本质上并不是传统存储增加一个接口,而是由 AI 推理需求反向推动的新架构。华为已经与国内头部互联网企业进行过实验性测试,从目前结果来看,传统文件存储和并行文件系统虽然能够承载 KV,但在访问路径、数据转换、介质寿命和推理协同等方面仍存在明显开销。
因此,未来竞争的关键是谁真正能够解决 KV 的容量、时延、调度、寿命和生态协同问题。