9 月 22 日,Anthropic 发布 Claude Opus 5.5,这是 Claude 5.5 系列的首款模型。
按照 Anthropic 的定位,Opus 仍是 Claude 三条主力产品线中能力最强、价格最高的一档,Sonnet 面向性能与成本相对均衡的场景,Haiku 则侧重速度和低成本。
与两个月前发布的 Opus 5 相比,Opus 5.5 并没有继续强调单纯扩大模型规模,而是将重点放在三个方向:提升编程、计算机操作和知识工作能力,降低完成真实任务的总体成本,以及强化复杂任务中的行为约束。
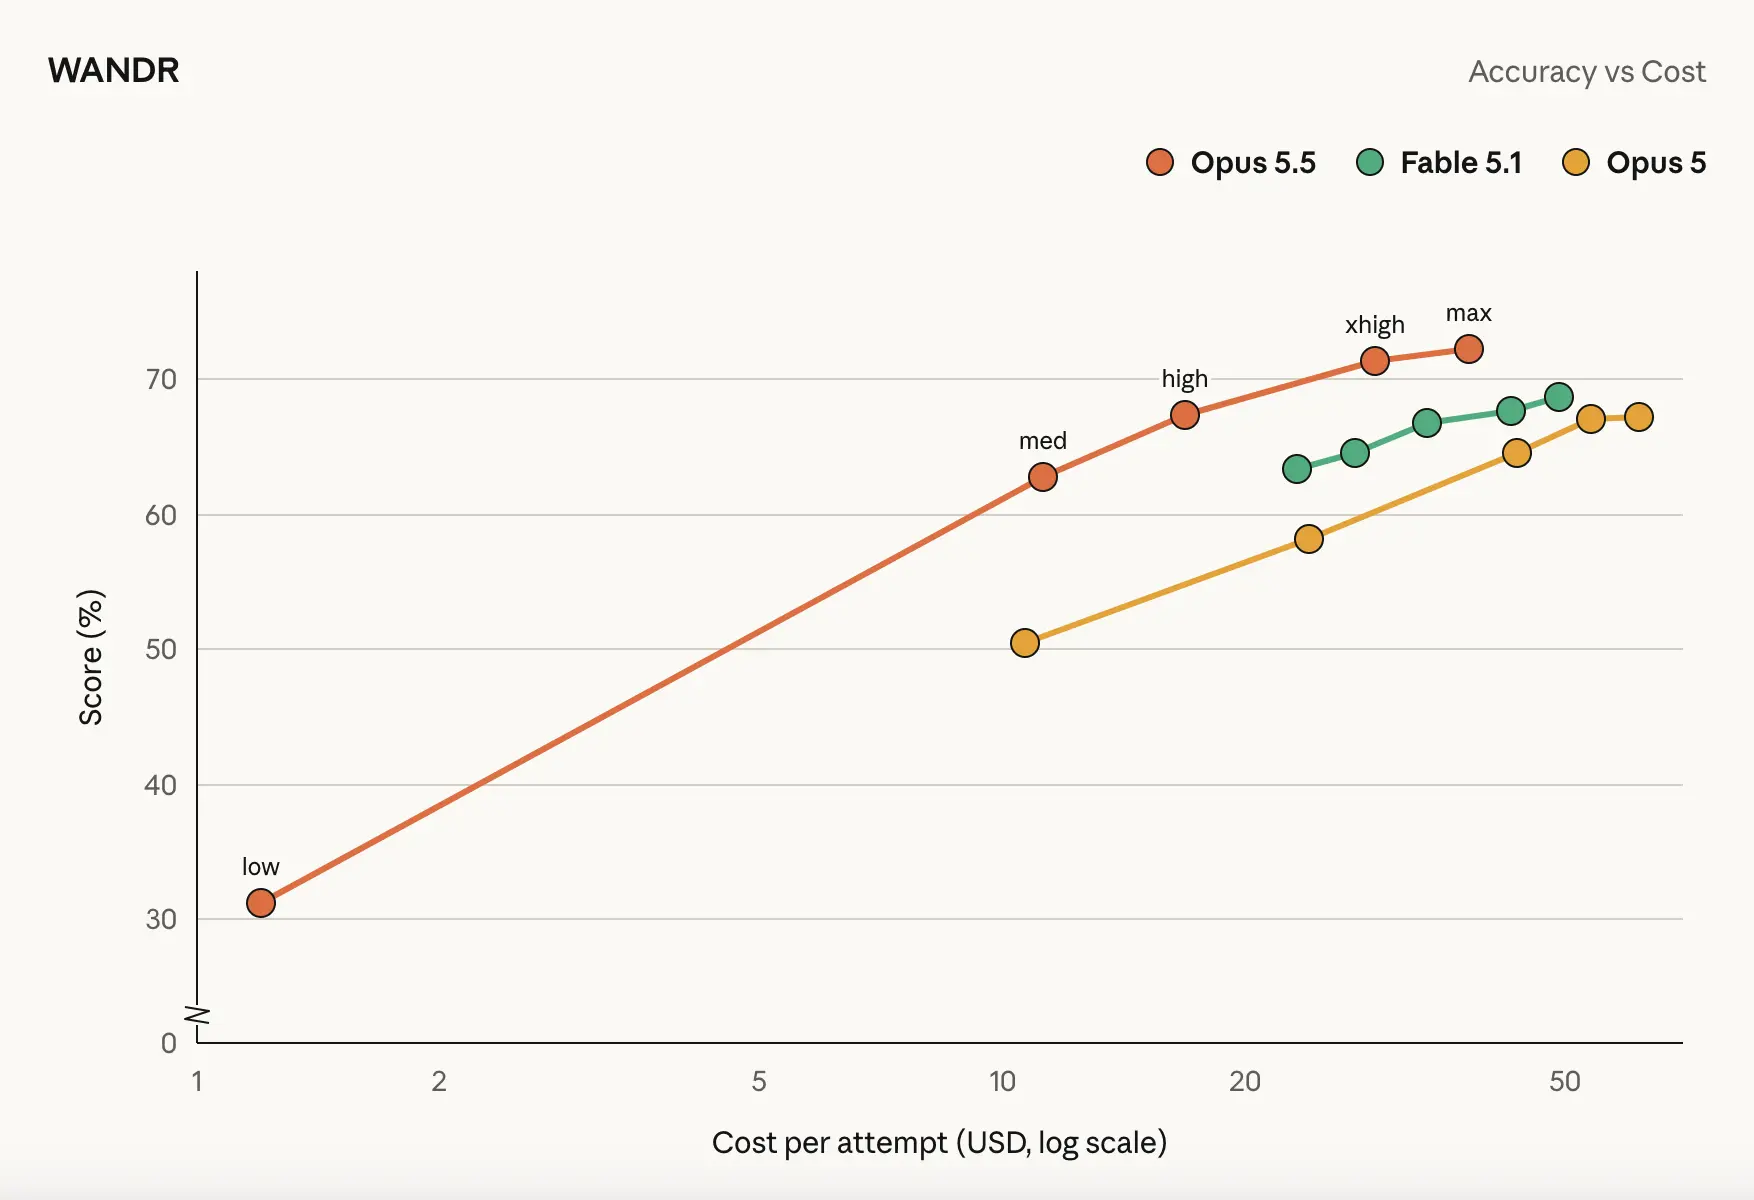
Anthropic 称,Opus 5.5 在多数工作中的表现已经达到 Claude Fable 5.1 的水平,但典型任务的运行成本比 Opus 5 降低约 40%。即将发布的 Sonnet 5.5 和 Haiku 5.5,也将采用类似的性能、效率和安全改进。
编码继续成为重点,曾一天内迁移 68 万行代码
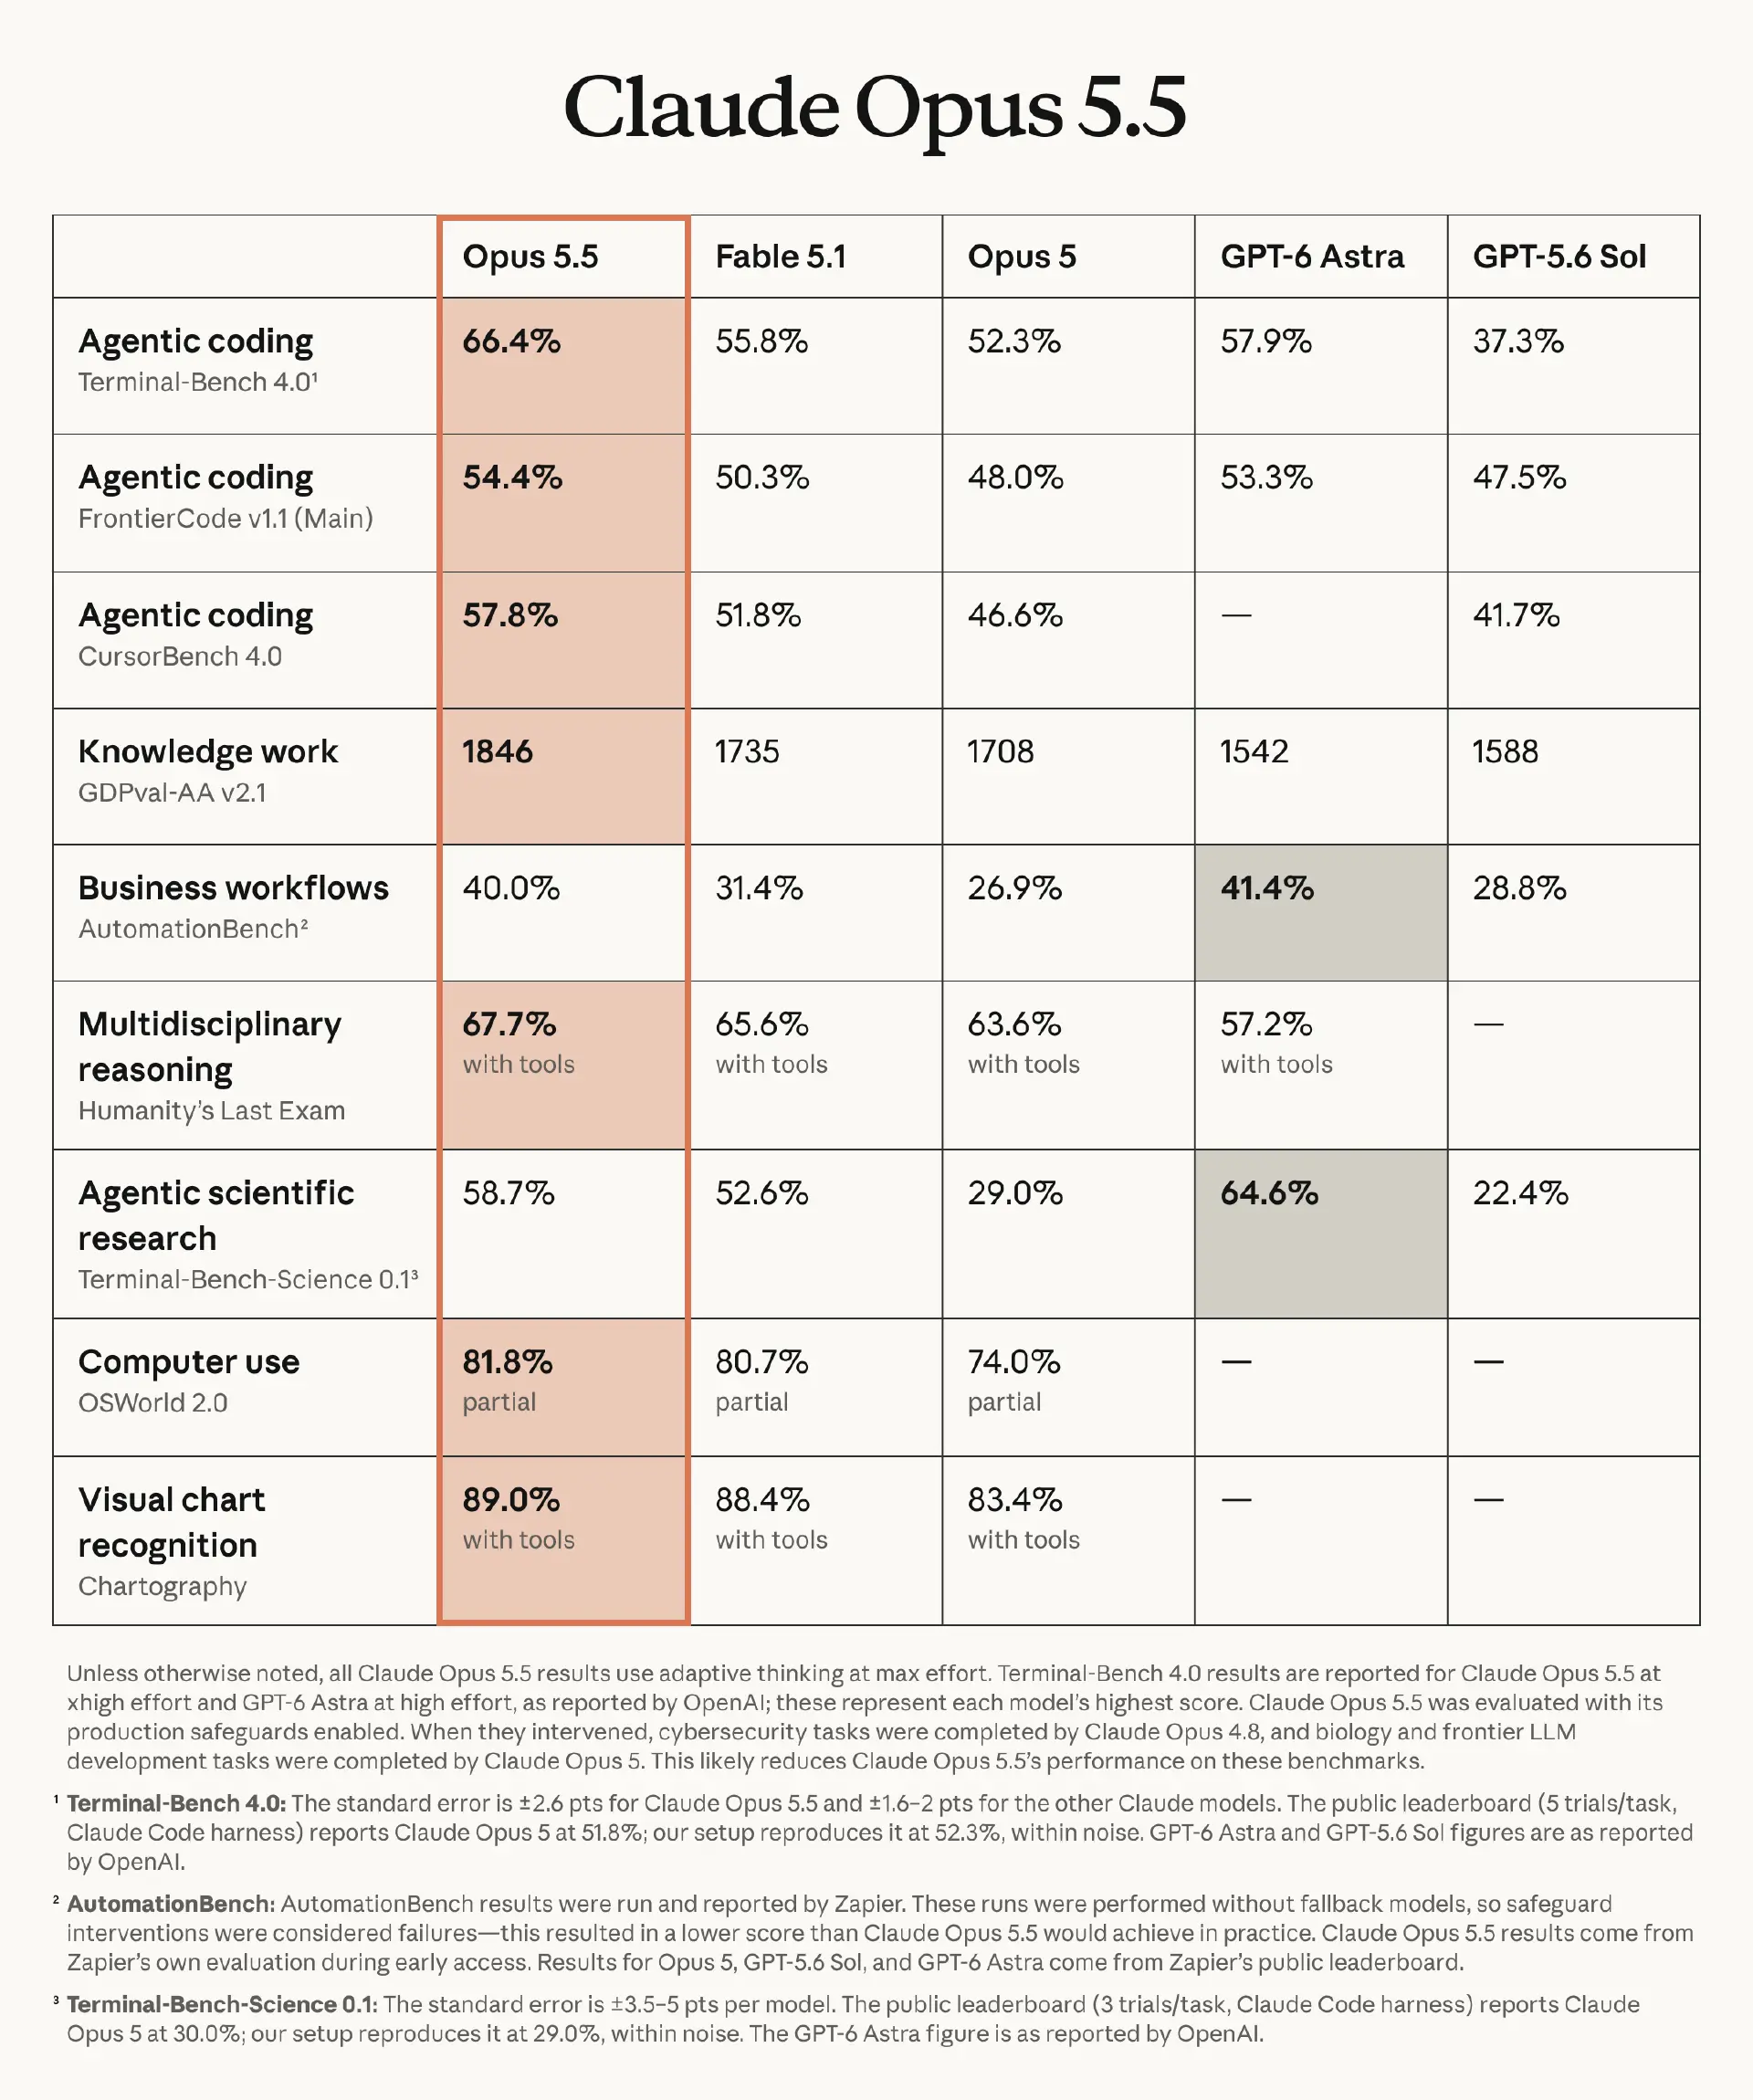
在 Anthropic 公布的测试中,Opus 5.5 主要提升集中在智能体编程、计算机使用和知识工作等场景。
Anthropic 表示,一名早期测试者使用 Opus 5.5 完成了一项涉及 68 万行代码的迁移任务,整个过程不到一天。
Anthropic 还称,如果由工程团队手动处理,这项工作可能需要数周时间。不过,这一案例来自早期测试者,并非标准化基准,实际效果仍会受到代码质量、迁移目标、测试覆盖率和人工介入程度等因素影响。

在另一项测试中,Anthropic 要求模型降低一个 Web 应用所有页面的加载时间。Opus 5.5 在 40 次测试中成功完成 39 次;相比之下,Opus 5 虽然也能进行优化,但改进幅度较小,有时还会改变应用原有行为。

此外,测试者让多款 Claude 模型根据同一条提示词开发游戏,Opus 5.5 在图形表现和完成度方面获得了最高评价。
这些案例反映出 Anthropic 试图改善的不只是代码能否运行,还包括模型在长任务中的完整性、修改范围和最终交付质量。
Anthropic 表示,Opus 5.5 在智能体编码方面取得了前沿成果,且成本仅为同类产品的几分之一。
在 FrontierCode 测试中,其默认工作量下,每项任务的成本约为 GPT-6 Astra 的 20%。

在 Terminal Bench 4.0 测试中,其成本约为 Astra 的 40%,性能与 Astra 持平。
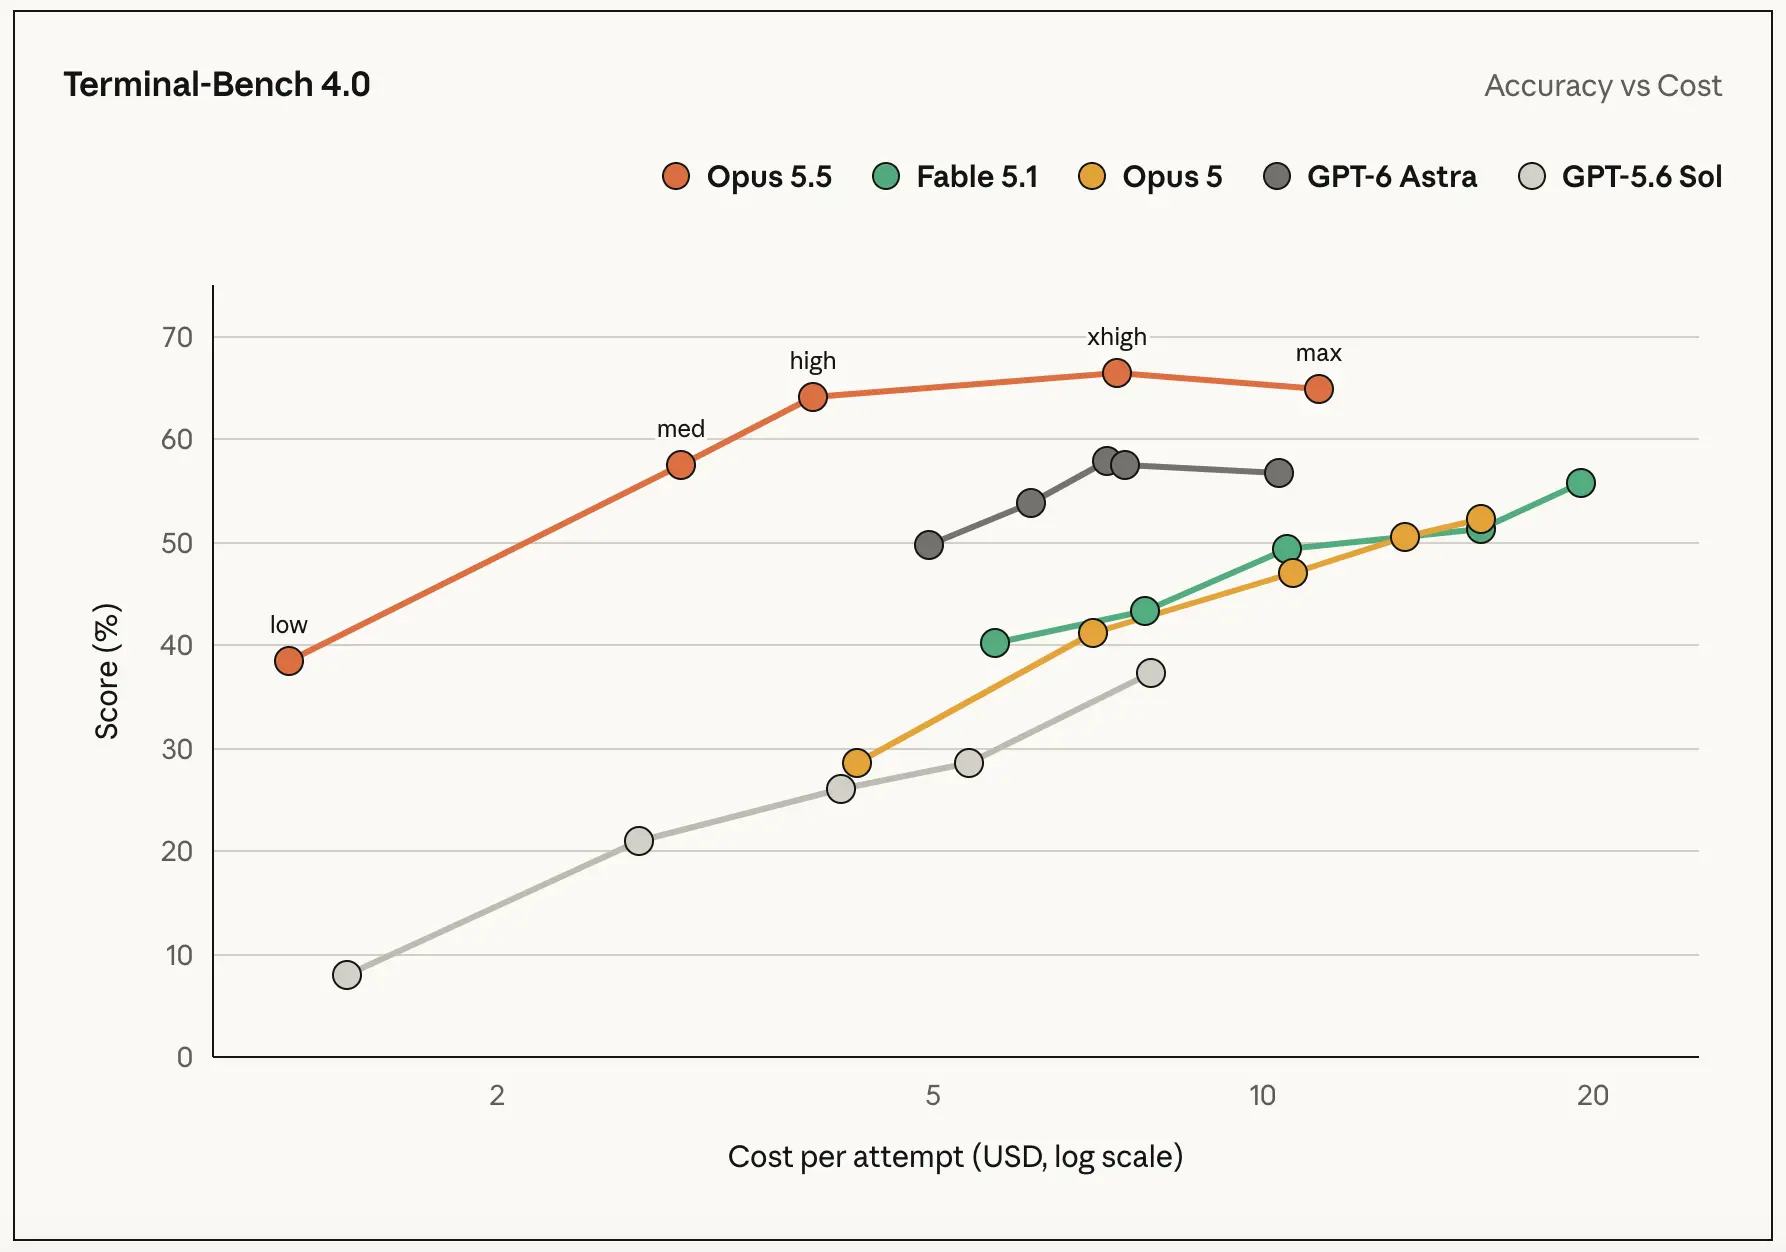
而在 CursorBench 测试中,其成本约为 GPT-5.6 Sol 的三分之一,性能却比 Sol 高出 11 分。

但该公司也承认,当模型能力接近时,几个百分点的基准差距已越来越难反映真实使用体验。在 Anthropic 内部使用中,Opus 5.5 与 Fable 5.1 之间的实际差距,比基准测试呈现的差距更小。
这也是此次发布中一个值得注意的变化:Anthropic 一方面将 Opus 5.5 称为新的主力模型,另一方面主动弱化了跑分的解释力,转而强调真实工作中的任务完成率、修改质量和长期协作体验。
在知识工作中,Opus 5.5 同样展现出了较强的实力。据 Anthropic 介绍,在一项内部测试中,团队要求 Opus 5.5、Fable 5.1 和 Opus 5 仅使用从网络上找到的信息撰写一份关于某公司季度业绩的报告,而该财报发布信息难以查找。
一个自动评分系统会核对每个数据和引文的来源。在不同的测试难度设置下,Opus 5.5 的 18 份报告中有 16 份达到了团队设定的质量标准,任何虚构的数据或引文都会被判定为不合格。而 Fable 5.1 和 Opus 5 在任何一次测试中都未能达到该标准。
Anthropic 还表示,Opus 5.5 在财务分析和商业工作方面也表现出色。投资公司 Walleye Capital 是早期测试者之一,他们报告称 Opus 5.5 在最低设置下基本解决了他们的评估套件问题;在更高设置下,它的表现更佳,甚至发现了评估说明中的一个错误并进行了修正。此前没有任何其他模型能够发现这个错误。
在另一项测试中,研发团队让 Opus 5.5 和 Opus 5 分析两家虚构的人力资源软件公司之间的拟议合并。两款软件都使用 Excel 构建了财务模型,然后将其转化为一份高管演示文稿,说明该交易在当前价格下是否合理。两个模型对交易的结论一致,但 Opus 5.5 的模型更加完善,演示文稿也更易于阅读,而 Opus 5 的演示文稿则存在一些小错误。Opus 5.5 的完成时间为 63 分钟,而 Opus 5 则耗时 93 分钟,并且 Opus 5.5 的制作成本也降低了 50%。
在知识工作评估方面,Opus 5.5 的表现优于其他模型,同时使用的 Token 数量也更少。在 GDPval-AA v2.1(一项涵盖 44 个职业的真实工作测试)中,Opus 5.5 的 Elo 得分高达 1846 分,领先于 Fable 5.1 和 Opus 5。
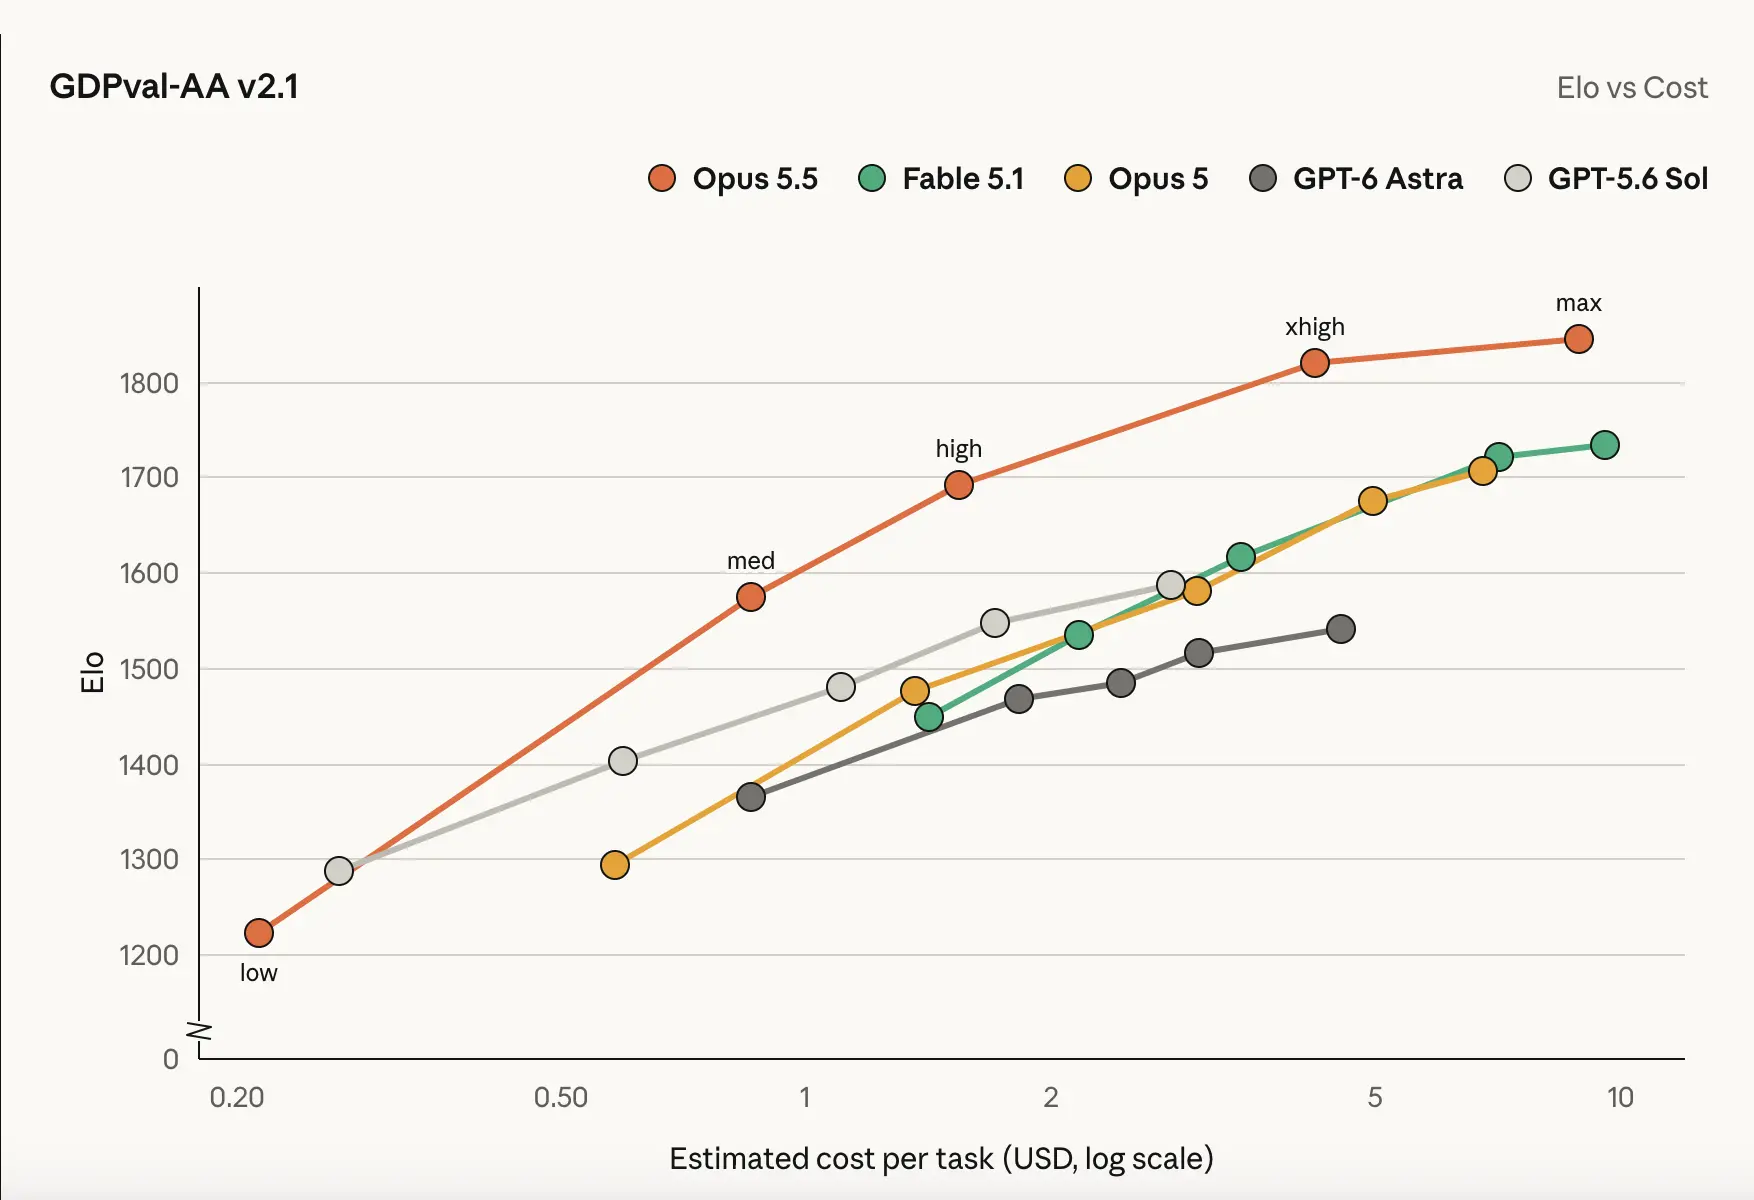
在默认工作量(中等)下,Opus 5.5 的单项任务成本约为 GPT-6 Astra 的五分之一,但在最高工作量下,其性能却优于后者。此外,在衡量业务流程和大规模数据收集的基准测试中,Opus 5.5 的表现也优于其他模型。

除了上述这些能力提升外,Anthropic 评估认为,Opus 5.5 在生物学和网络安全方面的能力已经与 Claude Mythos 5.1 相当。由于这两类能力具有较明显的双重用途,公司决定为 Opus 5.5 部署与 Fable 5.1 类似的安全措施。
这些限制主要针对风险较高的任务,例如从编译后的二进制程序中发现可利用漏洞,或者提供可能帮助识别和开发生物武器的技术信息。普通源代码审查、防御性漏洞分析和常规生命科学研究并非全部禁止,但部分高能力功能需要经过组织和人员验证。
符合条件的机构可以申请 Anthropic 的生命科学验证计划,以使用 Opus 5.5 开展生物学研究。Anthropic 还计划在未来几周扩大网络安全验证计划,让经过验证的安全从业者获得更完整的模型能力。
这意味着,Opus 5.5 的能力升级并不会对所有用户完全开放。Anthropic 正在尝试通过身份验证、用途审查和实时安全机制,在专业研究需求与滥用风险之间划出边界。
Token 单价下降 20%,典型任务成本降低 40%
价格是 Opus 5.5 相比上一代最直观的变化之一。
Opus 5.5 的 API 输入价格为每百万 Token 4 美元,输出价格为每百万 Token 20 美元;Opus 5 对应价格分别为 5 美元和 25 美元,输入与输出单价均下降 20%。缓存读取价格从每百万 Token 0.5 美元降至 0.2 美元,降幅达到 60%。
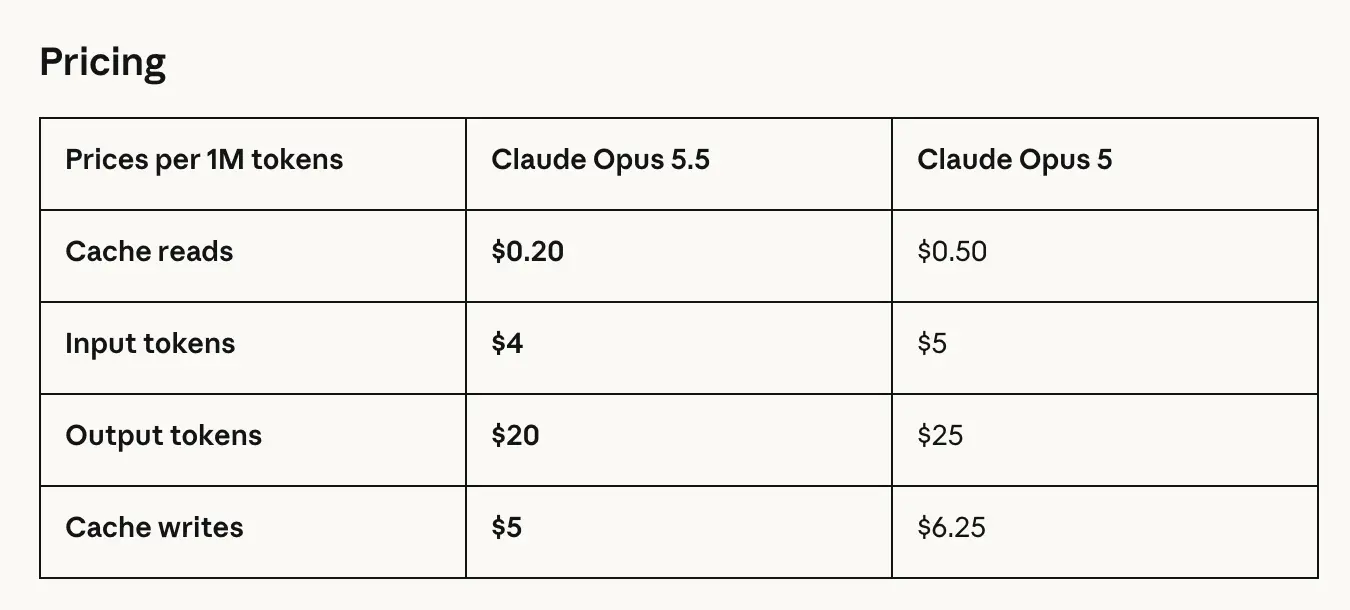
但有一个需要注意的点是,Anthropic 所说的“成本降低 40%”并不是说所有 Token 的单价都下降 40%。
输入和输出单价实际下降 20%,缓存读取下降 60%;再叠加模型以更少步骤和 Token 完成任务,Anthropic 测算其在默认设置下的典型工作负载总成本比 Opus 5 低约 40%。
这种计算方式对 Coding Agent 尤其重要。
为啥这么说?因为此类任务需要模型反复读取代码库、调用工具、运行测试并修改文件,缓存读取往往占据较大比例。所以缓存价格下调带来的成本变化可能高于表面的输入、输出 Token 降价。
价格降低的同时,模型速度也有明显提升。
在速度方面,Anthropic 称 Opus 5.5 生成输出的速度比 Opus 5 快 30% 以上,背后原因是其服务推理所需的总体计算资源下降。公司同时提高了 Pro、Max、Team 和按席位计费的 Enterprise 计划的五小时使用额度,并允许订阅用户保存一次额度重置机会,在需要时使用。
Opus 定位变了:不再只追求最强,要“够强且更便宜”
作为 Anthropic 首款在“放慢前沿”倡议后发布的模型,Opus 追求的方向似乎发生了一些变化:不再只追求最强,而是追求“够强且更便宜”。
Opus 5.5 是 Anthropic CEO Dario Amodei 呼吁“控制前沿能力推进节奏”后,公司发布的首款大模型。
需要说明的是,Amodei 所说的“pacing the frontier”并不是暂停模型训练或停止技术进步,而是让模型能力提升速度与对齐、安全防护及第三方评估能力尽量保持同步。他提出,前沿模型公司应向外部评估机构持续开放模型和训练流程,并推动行业建立共同安全标准。
按照 Anthropic 披露的信息,Opus 5.5 发布前接受了 Frontier Design 和 METR 等外部机构的测试。在 Anthropic 内部的自动化行为审计中,Opus 5.5 取得了该公司历次受测模型中的最高成绩。
这套审计覆盖数千个模拟情景,重点观察模型是否会采取难以逆转的行动、超出用户授予的权限,或者在遭遇提示词注入时偏离原始任务。Anthropic 称,Opus 5.5 相比近期模型更少越过既定边界,对提示词注入的抵抗能力也强于 Opus 5。
此次测试范围还扩展到更长时间的任务、理论上无法完成的任务,以及参考真实事故设计的场景。不过,Anthropic 同时承认,这些评估并不能覆盖模型部署后的所有行为,Opus 5.5 仍然存在局限。
该款新模型发布的时间点很有意思,Opus 5.5 距离 Opus 5 发布仅过去了大概两个月。上一代 Opus 5 的定位,是以相对较低的价格接近 Fable 系列能力;到了 Opus 5.5,Anthropic 进一步将性能、成本和运行效率放在同一套叙事中。
从公布的信息看,新模型最值得关注的可能不再是某一个基准测试超过了谁,而是这背后释放出的一种信号——前沿模型的竞争方式正在发生变化:当编码和智能体能力逐渐接近后,厂商开始比较完成同一任务需要多少 Token、运行多长时间、调用多少次工具,以及是否能避免修改应用原有行为。
Opus 5.5 的输入、输出 Token 价格只下降了 20%,但 Anthropic 将典型任务成本降幅定为 40%,正是因为评价单位正在从“每百万 Token 多少钱”,转向“完成一个真实任务需要多少钱”。
有消息称,Sonnet 5.5 和 Haiku 5.5 也将在未来几周发布。届时,Opus 5.5 所采用的效率和安全改进将进一步下沉到中端与轻量级模型,Claude 5.5 系列的完整定位到那时应该会更加清晰。
参考链接: