梦瑶 发自 凹非寺
量子位 | 公众号 QbitAI
这年头,实时生成的世界模型越来越会「造世界」了。
画面更夯,控制更细,但一旦走到实时生成这一步,继续往上做能力,就会有个很难绕开的坎:
能力越强,实时越难守,整个行业也因此苦既要又要的增长难题久矣。
更麻烦的是,实时世界模型还得面对世界模型的共性难题,相比LLM,能力想沿着稳定路径持续增长也没那么容易。
然而,这个困扰行业多年的实时世界模型的老bug,如今,已经有厂商用实际模型完成验证并跑出了答案——
实时性和通用能力,世界模型可以全都要。
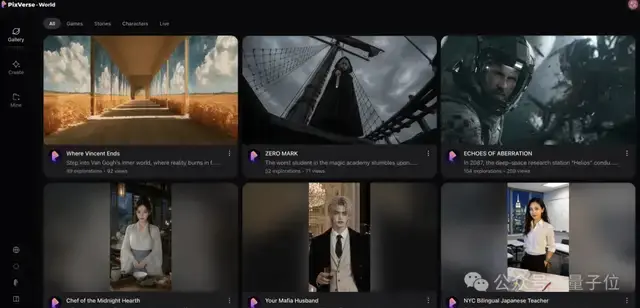
这个玩家的名字大家应该不陌生:爱诗科技。
其实今年1月的时候,爱诗就发布了首个通用实时世界模型R1,主打持续生成能力,当时直接在网上火出圈了一波。
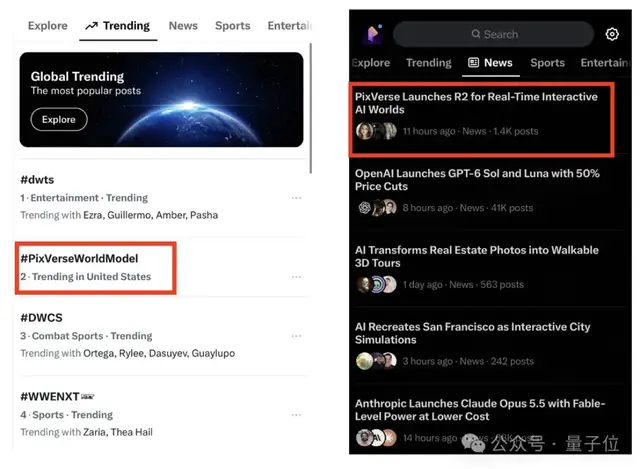
就在这两天,全新的实时世界模型PixVerse R2,也上线了。
甚至一经上线,模型就直接冲到了X平台的热度总榜——
这回,R2直接把LLM里那套规模继续加、能力继续涨的Scaling逻辑,真正搬进实时世界模型里。
基于统一可扩展的世界模型框架,R2把完整的时空关系压进模型,让场景能够沿着时间持续演化,前后状态保持一致,让这个世界真正「记得住」。
不仅如此,R2还把文字、图像、声音、动作统一进模型,边生成边响应、音画同步,让世界真正「控得动」。
比如下面这个探险世界,用户不仅可以控制方向,还能基于Prompt控制场景角色,而且画面是实时生成的内种:
文章链接:
https://mp.weixin.qq.com/s/h-YfJ-3Vd1rKuwgsZtbhQA
当然,脑洞完全可以再大一点,比如游戏剧情也能DIY,一句指令就能改变眼前世界,世界剧情真·随意拿捏了:
文章链接:
https://mp.weixin.qq.com/s/h-YfJ-3Vd1rKuwgsZtbhQA
过去实时世界模型最大的难题之一,就是能力一旦往上堆,速度、稳定性和交互性往往也开始彼此拉扯。
当实时和通用能力同时成立,世界模型的能力边界和使用边界也会一起外扩,逐渐进入游戏、虚拟交互等场景。
一种新的数字世界底座,这回,开始有了成形的可能。
从Scaling到能力预算,实时世界模型连撞两堵工程墙
说实话,还真不能怪实时世界模型这么多年一直卡在能力增长这件事上。
主要在于,实时世界模型想把能力继续往上做,前面先横着技术工程上的两道「硬门槛」。
其中第一道门槛,便是整个视觉世界建模都绕不开的一道表征难题:「信息」到底该怎么被统一表示和建模?
虽同样都隶属模型大类,世界模型在这件事上的先天条件,其实真没LLM那么友好。。。
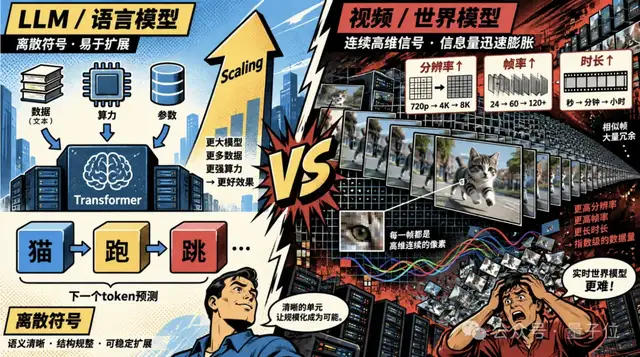
LLM里的第二个L,就是Language(语言)。
好巧不巧的是,语言其实在信息形态上天然就占了便宜,因为它可以被压缩成一套离散、序列化的符号系统。
在这套体系下,每个Token都是边界清晰的语义单元,海量文本都可以被统一成有限符号的排列组合,训练任务也被高度归一为「预测下一个Token」。
于是,数据、参数和算力都能沿着同一套框架持续扩展,资源投入也更容易稳定转化为能力增长,这正是LLM能够充分释放Scaling潜力的底层前提。
但扎心的是,到了世界模型这里,这套逻辑就没那么顺了。(doge)
因为图像和视频是一种连续、高维且高度冗余的信息形态,色彩、光影连续变化,单个画面就包含海量视觉变量,相邻像素和视频帧之间又存在大量重复。
此外,模型还得从这些原始信号中进一步抽取语义、状态变化乃至物理关系,信息结构远比文本复杂。
也因此,视觉领域长期缺少一套像文本Token那样紧凑、统一、可持续扩展的表征体系,视频模型想沿着同一条路径持续增长,天然要难得多。
△AI生成
当然了,这还只是第一层难题。
因为一旦再加上实时两个字,难度还会再高一档,这也是实时世界模型面对的第二层门槛:
模型容量和实时计算预算天然互相拉扯。
想维持稳定实时生成,每一帧留给模型的计算窗口可能只有几十毫秒,可世界模型想理解更多场景、更复杂的物理关系和更长程的时空变化,又需要更大的模型容量、更复杂的建模,以及更多计算。
这也解释了为什么,过去世界模型的扩展更多停留在局部能力上——
画质、时长、场景各自往前猛堆,却很难汇成一条稳定、统一的增长曲线。
这个两难问题,甚至早已被头部模型反复验证。
2024年,Google DeepMind 11B参数的Genie已经能生成可交互环境,但到了Genie 2,场景和物理能力继续增强,实时性却更难兼顾,想跑到实时往往需要以蒸馏为代价,同时还要牺牲部分画质。
换句话说,对实时世界模型而言,真正难的从来都不是单独把模型做大,或者单独把速度做快,而是让通用能力和实时运行能够同时成立。
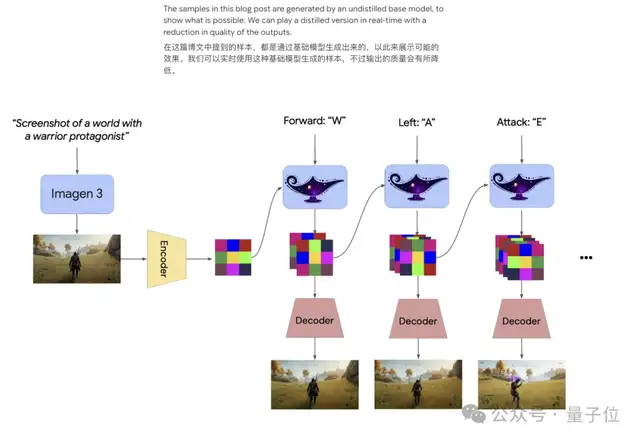
△Google DeepMind Genie 2报告
PixVerse R2:实时世界模型终于有了自己的增长曲线
所以说到这儿,实时世界模型碰到的难题就很清楚了。
想把实时性和通用能力一起做上去,先得解决一个底层问题——更多数据、任务和交互信号,怎么持续进入同一套能力体系。
前面我们说过,LLM能够持续Scaling,一个重要前提,就是语言本身拥有相对统一的Token表示和序列建模方式。
但对于实时世界模型来说,模型面对的不只有视觉,还包括动作、音频、长短不一的时间尺度,以及不断进入的各种控制信号!!
这些信息的数据形态、时间粒度和作用方式都不一样,想让这些能力继续一起增长,首先就得把它们收进一条统一的建模主线里。
而PixVerse R2这次做的一件关键的事——
便是把视觉、动作、音频、时序以及不同控制信号,放进同一套可持续扩展的因果建模框架。
需要提一嘴的是,这里的Scaling可不单单指的是模型大小,还包括世界复杂度、控制力,以及怎么稳定运行~
更关键的是,当这些原本异构的信号开始被放进同一种表示体系里,复杂动态的世界也就有机会拥有一套类似语言Token的统一计算坐标系。
而这触及的也是Scaling最底层的问题——
新增的数据、任务和交互经验,能不能持续沉淀进同一个能力体系,并形成复利。
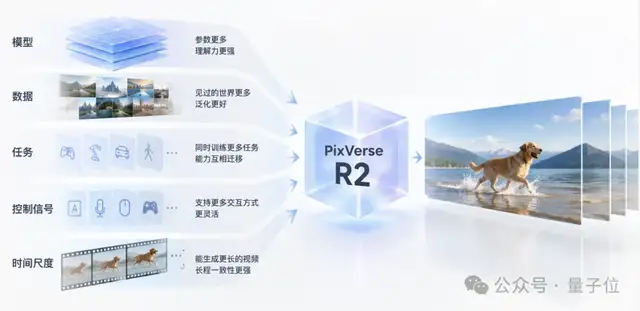
具体来说,R2把Scaling拆成了模型、数据、任务、控制信号和时间尺度五个彼此「协同增长」的维度。
模型规模决定容量,数据拓宽世界分布,任务强化跨场景迁移,控制信号增加交互精度,时间尺度则决定模型能把多长、多复杂的动态过程纳入建模。
任意一个维度增加资源,都能反过来增益其他维度,模型的整体能力就会上涨,不依赖单纯扩大参数量。
这也就意味着R2真正扩展的,已经开始从参数规模进入世界状态空间本身。
其实传统Scaling走到后期,一个越来越现实的问题,就是资源继续往上堆积,能力增益却未必还能同比例增长,新增算力和数据的边际收益开始变薄。
反观R2做的事情,更像是在世界模型身上重做投入产出逻辑,让每一份新增资源都拥有更多能力出口,最终更充分地沉淀为整体模型能力。
落到咱用户真实体验上,就是生成质量更高、长程一致性更稳、跨场景泛化更强,多模态控制也更细~
△AI生成
当然了,多说无益,这实时世界模型R2到底能不能打,我们直接看实际效果~
先插一句,这次R2相比上一代R1,能玩的东西明显更多了。
就比如我们不仅能在赛博世界中玩耍,甚至还能体验互动影游和实时数字人。
先来个小试牛刀,前阵子刚看完《奥德赛》,于是我索性一头扎进了一个奥德赛草原风格的世界里,现场勇闯一下:
真别说,多少有点玩家、导演、编剧三权合一内味儿了~(doge)
文章链接:
https://mp.weixin.qq.com/s/h-YfJ-3Vd1rKuwgsZtbhQA
WASD一按,视角和方向随便转动,Prompt一敲,角色动作、剧情走向也能直接改,可控性确实不错。
最重要的是,实际体验下来,几乎没有卡顿和延时问题,实际在场感确实强,实时性也确实丝滑。
接下来我们再上一波难度,直接玩一把互动影游,体验一把在魔法学院里魔法大乱斗:
文章链接:
https://mp.weixin.qq.com/s/h-YfJ-3Vd1rKuwgsZtbhQA
说实话,光看画面,还真有种穿越哈利波特电影里的感觉,确实蛮有大片感,画面质量过关~
但我最想说的,还不是画质,大家有没有发现,在这个互动影游里,眼前的世界是可以被你临时改写的。
比如直接在Prompt框里输入想使出的攻击魔法,下一秒画面就会顺着你的指令继续往下演,确实有点爽。。。
一段内容生成出来,实时性、画面、交互、记忆这些能力都能同时在线。
省下来的时间和精力,终于可以花在一件更重要的事上——到底想创造一个什么样的世界。
能力先拉满,实时再追回来
当然,问题也来了,R2到底是如何做到「实时」和「通用」能力既要又要的?
核心的答案,其实藏在其对底层技术路径的重新拆分上。
过去行业做实时生成底层技术设计,其实大多是在一笔固定的计算预算里「做减法」。
帧率和延迟一旦锁定,单帧算力预算也基本见顶。行业往往只能靠缩模型、减采样、压计算,把重模型塞进毫秒级窗口,生成质量、复杂运动和长程一致性也会随之受损。
但R2的一个关键技术设计思路是:让能力和实时分头强化。
先把基础模型的能力上限做高,再解决实时化,这样实时世界模型的天花板就不会过早被单帧计算预算锁死,而更多取决于底层模型本身能学到多少世界规律。
这也是R2整个技术体系里,Omni Causal AR和Real-Time Acceleration两层架构真正的分工,前者管能力上限,后者管实时性。
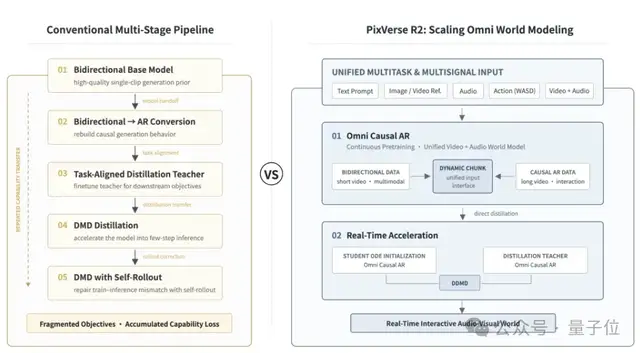
对于想持续Scaling的实时世界模型来说,一大难题在于模态、控制信号和时间尺度越加越多,建模很容易越做越碎。
所以第一步,Omni Causal AR先把短视频、长视频、多模态参考、音频和Action控制,统一进一套因果自回归框架——
通过动态Chunk适配不同时间尺度,再用Hybrid Teacher/Diffusion Forcing、多时间尺度记忆和Error Bank解决长程生成中的误差累积、角色漂移和状态断裂问题。
这样一来,新增数据、任务、控制信号和模型规模,都可以持续转化为更强的世界建模能力~
这边能力先做高之后,Real-Time Acceleration再接手第二道题——
把这套通用能力直接蒸馏进实时加速层。
持续预训练后,Omni Causal AR先把生成质量、长程状态和因果能力做扎实,再作为Teacher和Student共同的能力底座,让后续蒸馏尽可能沿用同一套世界理解逻辑,把这套能力更完整地压进实时预算里。
先造大脑,再给大脑做实时加速器,实时世界模型,这事儿成了。
说实话,爱诗能把实时世界模型在行业里率先跑出来,算不上太偶然。
长期面对亿级用户,意味着这家公司面对的一直都是真实世界里最难处理的那部分:
需求高度分散、场景持续变化、长尾永远收不完,模型每天都在被用户用各种意想不到的方式重新「考试」。
而世界模型最终要面对的,恰恰也是同一类问题:如何在一个持续变化、充满噪声、随时会被外部输入打断的环境里,维持状态、理解变化,并继续推演下一刻。
R2这种先放大能力、再单独解决实时效率的路线,也更像是长期产品实践和技术积累自然形成的一种架构选择。
当然了,更值得注意的是,这套架构一旦成立,它的外溢价值就很难只停留在视频生成层面。
在未来,内容生产、具身智能、虚拟人、游戏实时渲染,都可能逐渐汇向同一种底层能力:
持续理解环境、维持状态,并根据外部输入实时生成下一瞬间。
甚至在互动式娱乐市场这个生态场景里,这种变化可能会更明显。
剧情、场景和角色不再只是预先写好的固定内容,其会逐渐变成可以随着用户行为持续展开、持续变化的动态系统。
到那时创作者需要亲自定义的,也许会越来越少是某一帧、某一段资产,而越来越多地转向一个世界如何运转、角色如何行动,以及规则本身。
由此,互动娱乐真正进入的,可能是一个「内容不再被完成」的时代。
我们不再只是观看故事、操控角色、通关世界。
我们开始真正生活在一个会回应你、记住你,并因为你的存在而改变的数字世界里。