出品 | 网易智能
作者 | 小扣
编辑 | 王凤枝
Jev火得有点出乎意料。
它是TypeSafe推出的一款新AI模型,不写长答案,只做选择、评分和是非判断。大模型进入越来越长的工作流后,许多步骤不需要重新生成一段内容,只要决定下一步,这正是Jev瞄准的空档。
据Vercel公布的数据,Jev上线第一天,每100个付费团队里就有近13个调用了它,首日调用团队数超过此前新模型纪录的两倍。随后,Cloudflare提供了调用入口,LangChain和Langfuse也迅速跟进。
开发者可以把Jev放在大模型前后:任务开始前,它先判断该调用哪个工具或模型;大模型给出结果后,它再检查答案是否合格、流程要不要继续。复杂的推理和生成仍然交给大模型,Jev接走那些规则写不完、又不值得每次调用大模型的小判断。
这套分工是否成立,取决于Jev的判断能不能信。开发者通常会设置一道概率门槛,例如高于0.9就自动放行,拿不准的再交给大模型或人。Jev所说的0.9是否真代表九成把握,会直接影响整条工作流。

图:TypeSafe展示的一条安全工作流。Jev负责告警分类、处置和后续动作选择,最终动作仍由外围程序执行。来源:TypeSafe AI。
它接走的是大模型身边的小判断
TypeSafe把这类产品称为“System One”模型。开发者预先写好问题、选项和返回格式,程序拿到结果后便可直接进入下一步。官方价格是每百万输入Token 0.042美元,输出不收费;端到端延迟为70至500毫秒。和需要逐字生成答案的通用模型相比,它更像一条听得懂自然语言的if/else。

图:TypeSafe公布的结构化输出与工具调用错误率对比,Jev在其自建测试中的错误率均为0%。这是厂商自测,不是独立基准。来源:TypeSafe AI。
便宜、快,不等于什么都该交给它。TypeSafe列出的已知局限包括计数、数值运算和日期比较。代码能算清的金额、时间和数量,仍应留给代码;Jev适合处理的是“这条反馈更像投诉还是咨询”“这个操作是否可疑”“两件商品是不是同一款”之类的语义判断。
在自建工作流中,TypeSafe测得Jev最高可把速度提高193.6倍,成本降到对照模型的0.3%以下。
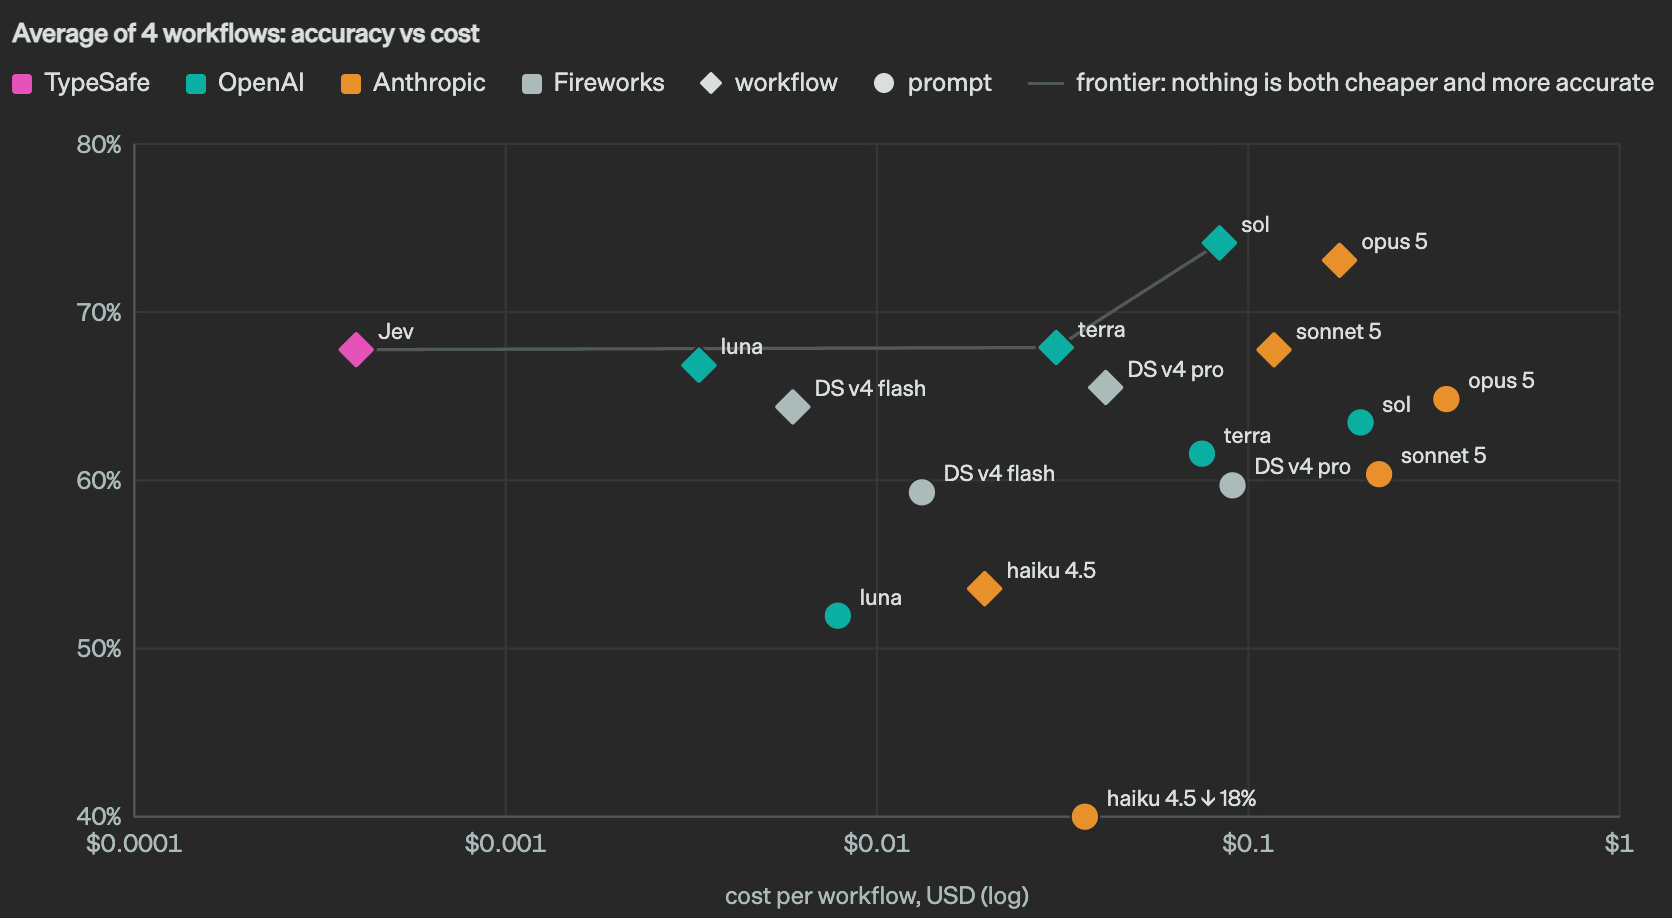
图:TypeSafe公布的工作流评测结果。这是厂商自测,不是独立基准。来源:TypeSafe AI。
厂商自测给出了很高的倍率,Every的一次试用则更接近日常用法。它拿37份文本分别做21项检查,Jev合计返回777个判断,耗时不到0.7秒,估算费用约0.0025美元。速度和费用已经足够诱人,准确率则要按具体任务重测。尤其是Jev把概率作为产品的一部分,开发者不只要看它选得对不对,还得知道它有没有高估自己的把握。
配合的前提,是它的概率能信
用概率划门槛,得先分清两件事:它有没有选对答案,以及它报出的把握是否可靠。开发者Charly Poly用Banking77做了一轮意图分类测试。这套数据包含77类银行业务,例如银行卡被吞、转账失败和修改个人信息。测试跑了三个随机种子,在验证集上选择门槛,再到留出的测试集报告结果。

据他公开的测试帖,Jev的宏平均F1为0.782,高于ModernBERT的0.712。在托管环境里,Jev的中位延迟为299毫秒,BART为5131毫秒。把自动处理的目标精度固定在90%后,Jev可以接下67.5%的样本,ModernBERT为35.7%。在这项意图路由任务里,Jev既快,也能在较高精度下多处理一部分请求。
问题出在它对概率的估计上。Jev声称有80%至95%把握的样本,实际正确率只有64%;还有6.6%的样本,正确标签被它打成了零概率。衡量概率与真实正确率差距的ECE指标,Jev也落后于ModernBERT。
GitHub项目jevcal用1600条Civil Comments判断结果做了另一轮测试。项目作者拿一半数据拟合Platt校准器,再到从未参与拟合的另一半数据上检验。校准后,Jev的Brier分数从0.0837降至0.0248;衡量排序能力的AUC仍为0.9264。
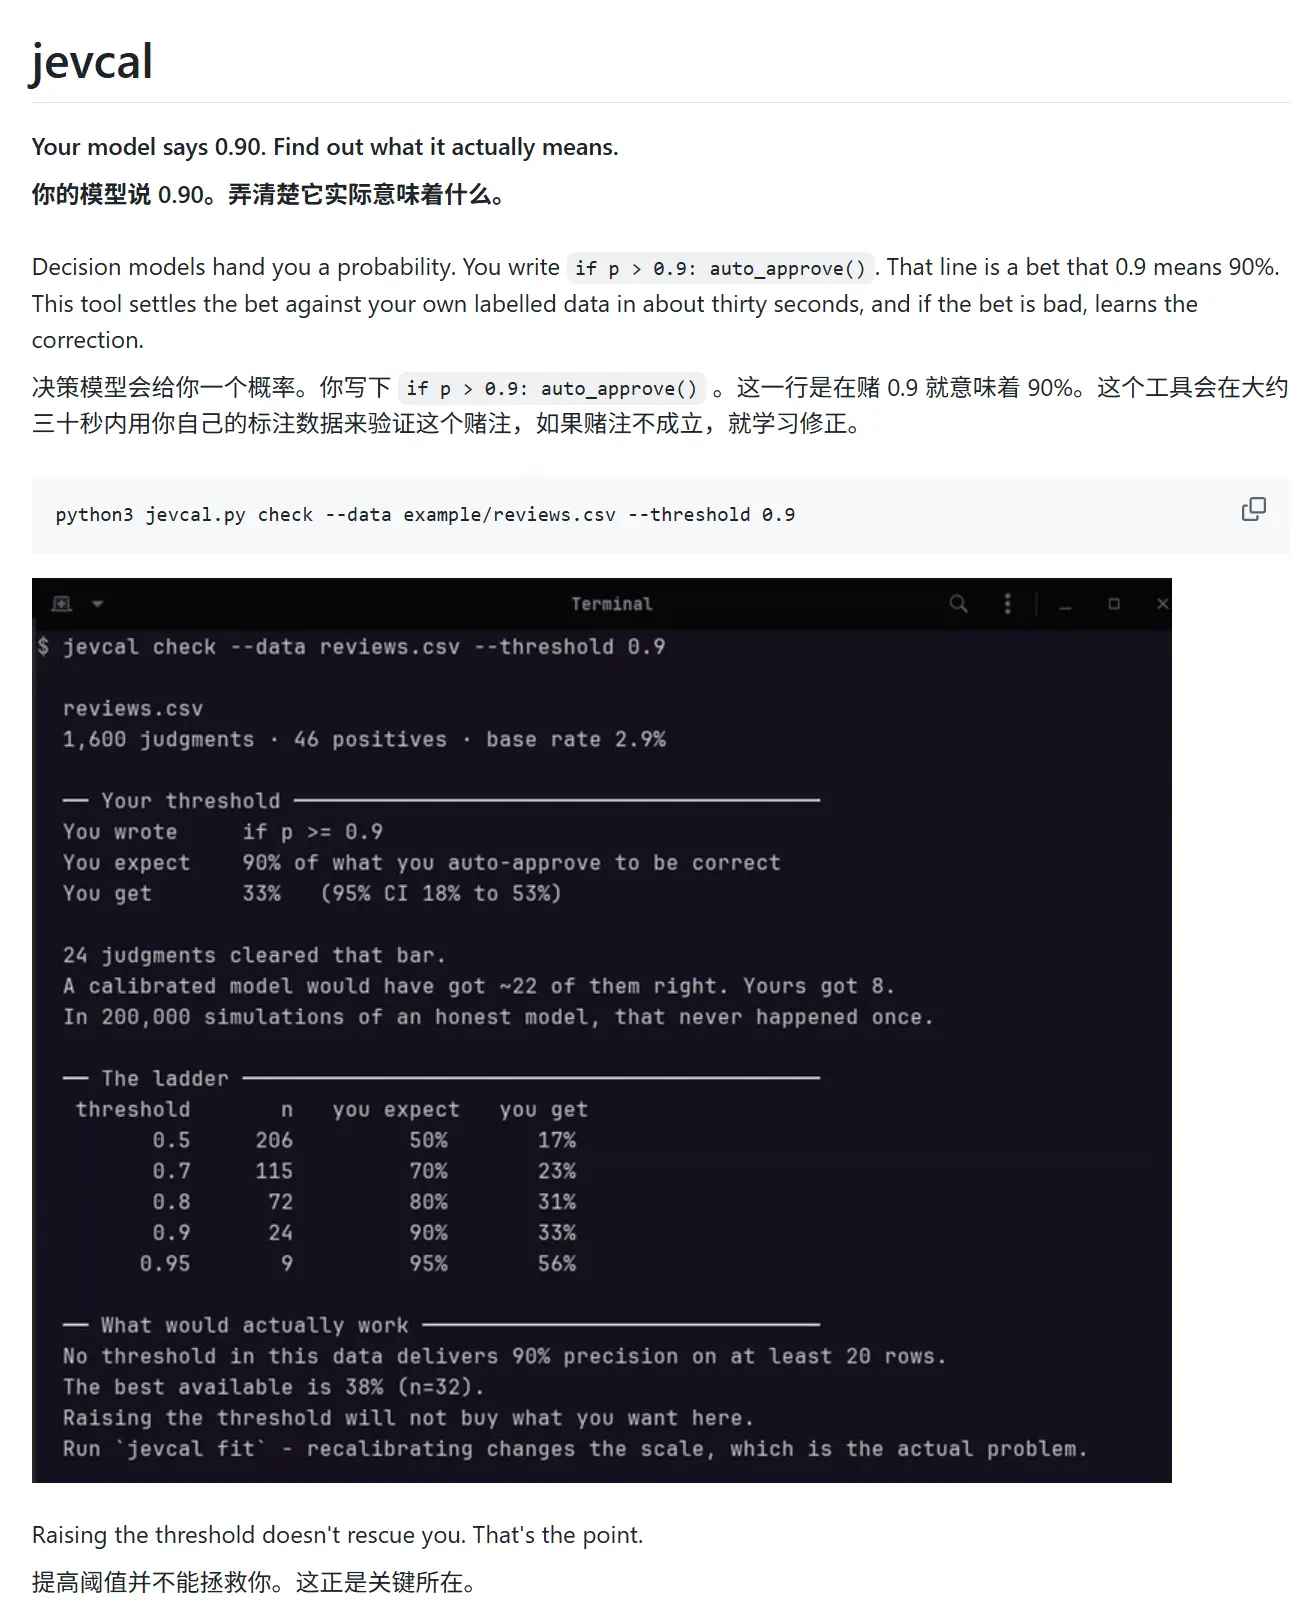
这次调整没有让Jev更会选答案,只是重新标定了它的概率刻度。jevcal使用的是另一项二分类任务,验证的是校准方法,不是Banking77中那6.6%零概率样本的修复结果。因此,模型返回的概率不能直接当作业务门槛。开发者需要先拿自己的数据重新校准,再决定哪些请求可以直接放行,哪些还得交给大模型或人。
复杂任务,要先拆成小判断
校准只能修正概率刻度,不能让Jev突然更会处理复杂问题。反钓鱼测试里,直接让它判断整封邮件,准确率只有62.6%,低于Claude Haiku的81.3%。研究者把问题拆成五个具体信号,再用逻辑回归汇总,Jev的准确率升到95.0%。
同样拆成五个小问题后,Jev的准确率为95.0%,Haiku为93.2%,只靠关键词和固定规则判断的传统程序为91.8%。Jev与Haiku的差距还不足以证明它更准,取得这五项判断的费用却约为Haiku的二十七分之一,速度约为五倍。在这项反钓鱼测试中,Jev的价值主要是便宜、快速地完成大量小判断,再由程序汇总;复杂任务仍不必直接交给它拍板。

开发者Patrick Dappollonio把同样的思路用在商品匹配产品Pricogni中。原系统留下9081组低置信度商品,原本都要人工复核。Jev只回答两件事:两条商品是不是同一件,主要差异属于哪一类。把握较大的结果自动归类,拿不准的继续留给人。
六路并发运行13分22秒,费用为0.32美元。最终49%的商品组被否定,21%被确认,还有30%留在人工队列。作者抽查的20个否定都站得住,20个确认中有两组仍可争议;大部分保留结果也确实需要人判断。这次,Jev的判断只被用来补充商品分类,没有直接改动商品状态或价格。它只是替人工筛掉一部分较容易判断的商品,把精力留给剩下的疑难项。
不是所有判断任务,都该交给Jev
反钓鱼和商品匹配的测试说明,Jev可以便宜地接下大量小判断。但这不等于工作流里只要出现“判断”,就值得额外调用一次Jev。
TokenTrim用5835条查询做了一组对照:先检索相似问题,再让Jev判断每道题的难度,把它交给相应的大模型;随后拿掉Jev,其他环节保持不变,看看准确率会不会下降。

加入相似问题检索和Jev后,准确率从最佳单模型的60.3%升到62.4%。但拿掉Jev、只保留检索,准确率仍是62.4%,成本还略低。至少在TokenTrim这套任务和路由方法中,真正带来提升的是检索,Jev给出的难度判断没有增加价值。
多加一层判断,也会多一个需要处理的故障。开发者Mnilax记录过一次工作流中断:Jev没有返回答案,智能体把沉默当成更安全的选择,整条流程停住,后来才由第二个智能体恢复。Jev如果负责决定大模型是否继续工作,超时、空结果和降级方案就得提前写好。
首日近13%的付费团队愿意试,Jev不缺尝鲜者。它能不能真正留下,要看拿掉它以后,工作流是否真的会变慢、变贵或变差。