【TechWeb】9月21日消息,今年8月,亚马逊云科技宣布计划的全球基础设施中新增部署200万颗英伟达GPU,全球AI算力竞赛再度升温。在中国市场,情绪正在从“计算焦虑”转向“计算理性”,投资回报率(ROI)和总拥有成本(TCO)成为企业决策的核心标尺。
Akamai云计算首席技术官Jay Jenkins时指出,AI基础设施的建设并非单纯的GPU军备竞赛,而是一场关于架构选择、成本测算与合规治理的理性计算。
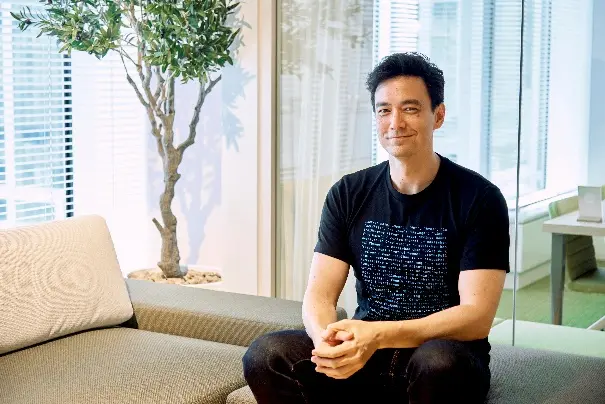
Akamai云计算首席技术官 Jay Jenkins
训练与推理:两种算力不能“一刀切”
面对国内企业普遍存在的算力不足问题,Jay Jenkins首先强调了一个被忽视的前提:训练和推理对计算能力的需求本质不同。
“训练和预训练阶段需求集中且高度自发,适合集中式GPU集群。但推理和训练后阶段具有全天候连续性、分布式架构和低延迟的特点,应优先考虑边缘或分布式部署,而不是简单复制训练期间的集中式架构。”Jay Jenkins表示。
他以Akamai的GoVeda案例说明,并非所有推理都需要GPU。这家公司在业务初期仅靠CPU即可满足推理需求;随着规模扩大迁移至GPU后,性能提升了30%,成本反而降低了20%。Jay Jenkins还特别区分了输入密集型应用(预填充型,如汇总密集型合约)与生成密集型应用(解码型,如交互式代码或文本生成),指出两者所需的内存和计算能力截然不同,计算能力配置必须分别评估,避免“一刀切”。
推理的隐性成本:被低估的账单
许多企业将推理等同于“购买GPU”,Jay Jenkins认为这是一种危险的简化。他在访谈中系统拆解了推理场景中的多重隐性成本。
基础设施运营成本。 数据在用户和中央服务器机房之间传输产生的网络带宽成本,以及因缺乏智能调度造成的GPU资源闲置浪费,构成了第一重隐性支出。他强调,强大的编排和服务软件对于将原始芯片转化为可靠吞吐量至关重要。
延迟导致的业务损失。 一组数据令人警醒:50%的AI部署在高峰负载下无法满足低于250毫秒的响应时间要求,直接影响客户满意度、服务成本和每位访客的收入。冷启动时间进一步加剧延迟,而这些性能瓶颈在多代理环境中会显著放大收入损失。
合规与安全治理成本。 跨境数据传输引发的监管合规成本,对API安全、模型保护和身份访问管理等安全防御措施的持续投资,以及“影子人工智能”带来的未经授权工具使用和数据泄露风险,构成了第三重隐性成本。
流量费用。 Jay Jenkins将流量称为“人工智能领域最大的隐性成本之一”。AI管道本质上依赖持续不断的数据传输,从云端到用户,再到边缘设备,传输费用会迅速累积。与延迟类似,多代理工作流会在每次数据交接中加剧这种数据传输。
ROI现状:75%-95%的投资未能转化为财务回报
Jay Jenkins坦承,当前人工智能计算能力的总体投资回报率仍处于“效率低、试错成本高”的阶段。约75%-95%的人工智能/计算能力投资未能转化为可衡量的财务回报,而真正实现规模化正投资回报率的公司比例仅为16%-25%左右。
那么,Akamai如何提高这一比率?Jay Jenkins从四个维度给出了答案:
分布式架构。 1200多个全球运营商网络、超过440万个跨越1200多个运营商网络的边缘节点,以及26个核心云节点,使数据无需长距离回传到中央数据中心。
灵活的计算能力选择。 多层计算产品线,包括CPU、GPU和专用VPU,可精确匹配特定场景。
推理优化技术。 结合专用推理GPU和CPU(如RTX 4000 Ada)以降低延迟、提高吞吐量;结合语义缓存、推测解码和基于意图的模型路由等技术,将优质的Blackwell GPU周期专门用于非缓存的复杂推理任务。
与NVIDIA AI Grid深度集成。 通过算法将工作负载调度到最佳位置,而非手动调度。通过将模型路由和推测性解码与Akamai的边缘编排相结合,消除冷启动性能损失,并在整个部署范围内保持较高的GPU利用率。
自建还是第三方?
对于企业如何评估推理业务、决定自建GPU还是采用第三方分布式推理云,Jay Jenkins给出了分阶段建议。
如果企业处于早期阶段且流量不稳定,应优先考虑第三方分布式推理云服务。循序渐进地发展是完全可以的,但随着技术和企业AI素养的提升,务必制定退出策略。如果项目已达到一定规模且有明确的长期负载预测,可以考虑采用自建基础设施与云计算相结合的混合方案,并利用开源模型进行定制,以降低长期代币成本。同时,务必考虑硬件折旧和过时问题。
评估TCO/ROI的关键指标包括:性能(冷启动、端到端延迟、吞吐量、出口流量等)、成本/折旧、能源需求、可扩展性、合规性和生命周期管理。
多智能体时代,延迟雪崩与风险放大
智能体时代的到来,让分布式推理架构面临新的挑战。Jay Jenkins用一组直观的数字揭示了问题的严重性:单个AI请求的延迟40-100毫秒是可以接受的,但多智能体系统可能生成数百个请求,累积延迟可能会从40毫秒增加到4秒甚至40秒。
除了延迟累积,代理间通信的复杂性同样不容忽视。这不仅涉及模型推理,还涉及代理之间以及代理与API之间的实时协作(东西向流量),需要本地代理通信和部署在协调器附近以加速集成。代理全天候运行,对基础设施的持续高强度处理能力提出了极高要求。
更值得警惕的是风险放大效应。Jay Jenkins指出,智能代理自主执行任务意味着错误指令的影响会在每个阶段被放大。当代理自主地跨工具和数据库调用API时,一个被篡改的提示符或有缺陷的输出就如同万能钥匙。传统的边界防火墙无法检测到这种内部通信;遏制风险需要工作负载级别的微隔离和边缘端的实时API检测。
Jay Jenkins的观察指向同一个结论:AI基础设施的建设需要从“算力焦虑”走向“算力理性”。分布式架构、灵活的计算能力选择、智能编排与合规治理,正在成为企业在AI性能与成本效益之间取得平衡的关键支点。