智能家居社区 Home Assistant 最近出现了一个名为 HA-Jev 的插件。
它的逻辑极其简单,传感器读取洗衣机的功率变化与洗衣房门的状态,然后抛出一个问题给模型,「洗衣机洗完了,衣服是不是被忘在里面了?」模型不输出任何文字分析,只返回一个概率值。当置信度超过 0.8 时,手机就会弹出一则取衣提醒。
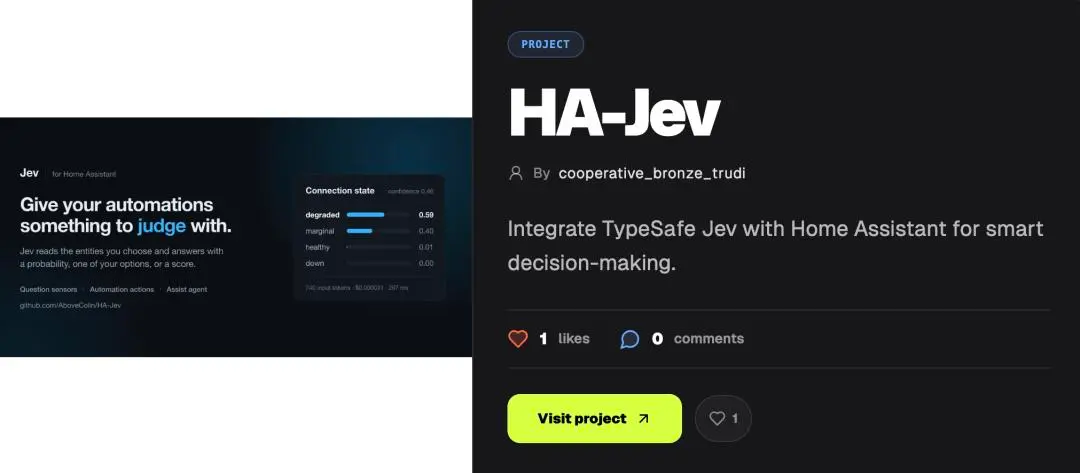
HA-Jev 仅仅用来提醒用户洗完的衣服是不是还留在洗衣机里|图片来源:pitchhut
一次判断耗时几十毫秒,花费 0.000015 美元。
插件开发者在论坛里留下一句意味深长的话,「我过去一直在用大语言模型回答根本不需要它的问题。衣服忘没忘拿是一个判断,不是一篇八股文。」
这句话恰好刺中了当前生成式 AI 的痛处。过去四年,整个行业把几乎所有的算力、资本和工程资源,都压在「教模型说出更流畅的人话」上。大家习惯了用百亿甚至千亿参数的庞然大物,先吐出一长串思考过程,再包装成礼貌体贴的自然语言,最后让开发者用复杂的正则表达式把需要的答案抠出来。
直到前 OpenAI 研究员 Diogo Almeida 带着他的新模型 Jev 登场。这个被称为「System One」的模型没有嘴巴,不生成任何文字,只输出概率判断。
上线不过数天,全球开发者围绕它疯狂砸出了近五百个开源项目。这可能是 Openclaw 之后
大家忽然发现,一旦剥离大模型的表达欲,原本昂贵而臃肿的 AI 应用,突然轻快得像一阵风。
01
大模型的「神经元」
如果把过去调用 GPT-5 或 Claude 的过程比作雇佣一位全知全能的哲学家,来帮你盯监控,那么开发者们现在用 Jev 所做的事,更像是给流水线装上了无数个廉价且反应灵敏的神经元。
在最耗费算力的 Agent 基础设施领域,这种变化几乎是颠覆性的。
过去开发者处理超长上下文,最常用的手段是让大模型做摘要。开发者 Tamara Tran 换了个思路,写了一个 Jev 插件用来压缩 Claude Code 的上下文。它不做任何归纳总结,而是逐条给历史工具调用的相关性打分,只要分值低于阈值,直接整条剔除。
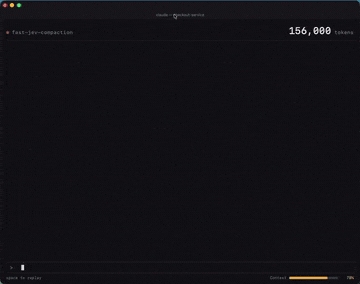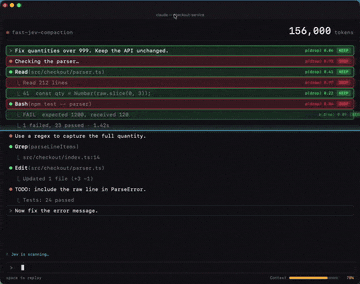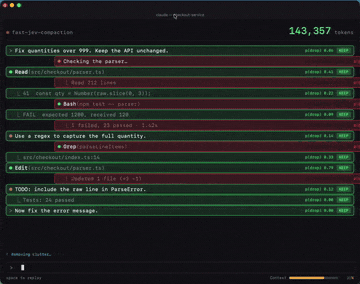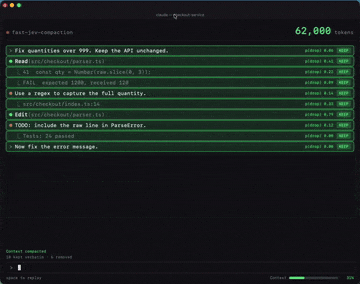
用 Jev 插件用来压缩 Claude Code 的上下文|图片来源:X
结果极其夸张,接近 100 万 token 的臃肿上下文,在 1 秒钟内被精简到 8.6 万,整个过程模型没有敲下一个字符。这里的洞察非常朴素,摘要是昂贵的生成行为,但过滤只是一次冷酷的判断。
类似的颠覆也发生在移动端自动化上。
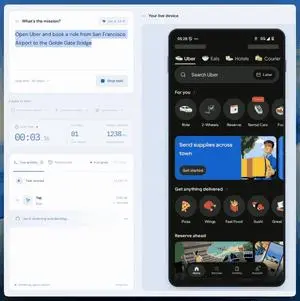
使用 mobile-jev 操作手机|图片来源:jevfast.com
Droidrun 团队做了一个名为 mobile-jev 的手机操作代理。在一段流出的演示中,它控制真实 Android 手机打开 Uber,输入起点和终点,一路精准点击直至付款界面,全程 9 个操作步骤仅耗时 21 秒。
整个流程没有调用过任何传统的文字生成大模型,文字输入是直接从用户指令中截取的纯文本片段,而每一个界面的下一步该点哪里、该滑动还是该确认,全部交给 Jev 做极速概率匹配。
除了操作界面,开发者们甚至把它塞进了最古老的基础设施里。
GitHub 上很快涌现出 pg-jev 和 duckdb-jev。开发者开始用自然语言,直接对数据库的行数据进行实时概率过滤和排序。在 Ruby 社区,有人直接把判断封装成了原生控制流语法,代码写出来就像是给程序赋予了直觉。
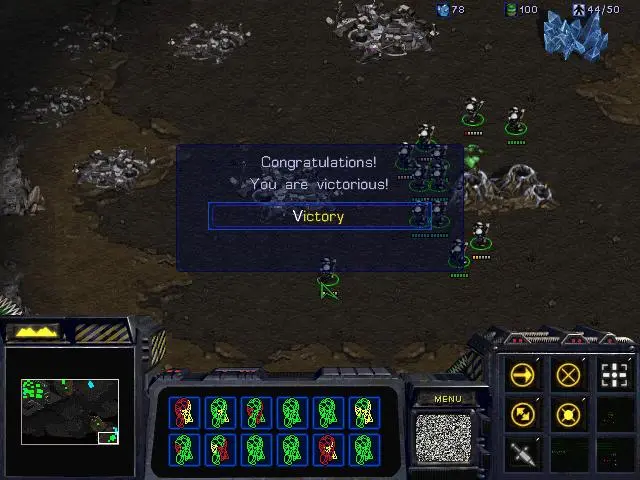
使用 Jev 打「星际」已经成了一系列 Github 项目|图片来源:Github
在游戏领域,有人让 Jev 操控模拟器状态去玩超级马里奥,有人让它驱动《毁灭战士》里的守卫,甚至有团队把它接入《星际争霸》完成了首个战斗任务。游戏需要的是几十毫秒内的操作决断,以往的大模型连第一帧的思路都还没理顺,游戏角色早就阵亡了。
甚至,在数据清洗这类脏活累活上,差距也大到令人发指。
一位开发者手头积压了三个月的产品匹配数据,共计 9081 条。早在六月份他就用主流大模型测算过,昂贵的 API 费用让他直接放弃。换成 Jev 后,他用一个晚上写了 150 行脚本,整个任务 13 分钟跑完,总账单只有 32 美分。
当大模型不再假装自己是一个博学的人类,AI 才能真正嵌入自动化软件的毛细血管。
02
杰文斯悖论
Jev 这个名字,取自 19 世纪英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。
经济学上著名的「杰文斯悖论」指出,当技术的进步提高了某种资源的利用效率,导致其使用成本大幅下降时,该资源的总消耗量不但不会减少,反而会呈现爆发式增长。
TypeSafe AI 给 Jev 定下的价格是每百万输入 token 仅需 0.042 美元,输出免费。按照这个资费,一天进行 1 万次业务决策,单月成本在 120 美元左右。而在以往,如果使用同等准确率的顶级推理大模型做这套流程,每月账单会直奔 3.5 万美元。
暴跌的成本,瞬间激活了那些此前被判定为「毫无商业价值」的边缘场景。
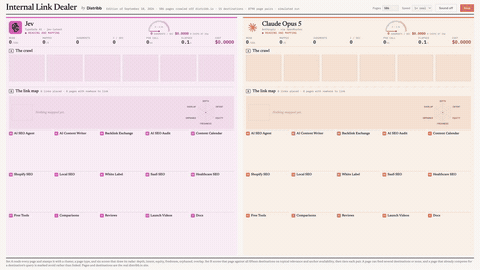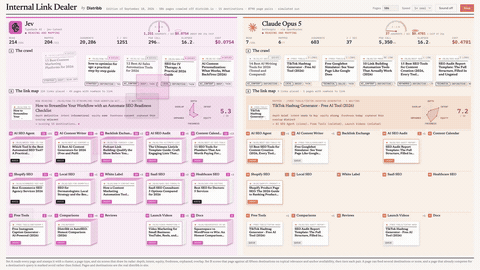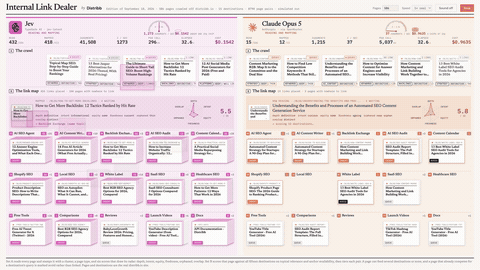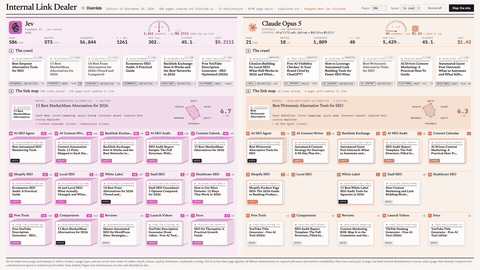
用 Jev 做 SEO 速度惊人|图片来源:X
在内容分析领域,Distribb 的创始人拿 Jev 扫描了近六百个网页,在 45 秒内完成了内部链接地图的重构,布设了五百多个链接,总共花费 21 美分。在过去,如果让顶级大模型来做这件事,同样的时间里连二十个页面都读不完。
那位创始人的感叹切中了本质,「这不是内容创作,这只是 8790 次判断该连还是不该连的决策题。」
这也解释了为什么创始人 Diogo Almeida 在离开 OpenAI 时会留下那句感叹,「我们手里握着一道闪电,但它却没那么好用。」
作为参与过构建 ChatGPT、共同发明 RLHF 的核心研究员,Almeida 的反思带着一种行业局内人的冷酷。在他看来,整个行业被困在「优化人类自然语言」这条死胡同里太久了。
计算机之间协同并不需要抑扬顿挫的修辞,机器需要的是明确的指令与概率。过去四年 AI 界花费数千亿美元调教出来的语言能力,在严肃的系统工程面前,大部分时间反而是低效的阻碍。
Pi 框架的 CTO Armin Ronacher 谈到这一现象时直言不讳,「我们早该意识到这一点的。只因为此前主流大模型一直被风投资本补贴得极为廉价,大家都习惯了挥霍,没人愿意去做真正的创造性思考。」
一旦这种廉价幻象被打破,架构设计的转向便不可逆转。
大模型,正在退回它原本该在的位置。
它不应该当中央处理器,它更适合做前端的公关发言人。在未来的系统架构里,海量的毫秒级判断交给便宜得像自来水一样的直觉模型,只有在真正需要向人类用户输出成段文字、提供情绪价值或者起草复杂长篇报告的极少数节点,才需要把那个昂贵的生成式模型唤醒。
03
「判断」和「生成」分家
回看过去三年的 AI 叙事,主线一直是「大模型越来越大、越来越聪明、越来越全能」。一个模型既能聊天,又能写代码,还能看图做表,什么都会。整个行业默认「智能」是一块铁板,不可拆分。
Jev 的出现,撕开了这块铁板。它证明了有些工作需要推理和表达,有些只需要快速判断。把两者绑在一起,是一种结构性的浪费。
Jev 的大火,点燃了开源社区的热情|图片来源:Google DeepMind
Jev 上线仅一天,开源社区就已经跟进。vLLM 贡献者用 Google 的 DiffusionGemma 迅速搞出了开源版本,初步测试准确率接近官方。这说明「判断模型」作为一个品类已经成立,而不仅仅是一家公司的产品创新。
更值得注意的是下游的架构变化。在 Jev 催化的新范式里,一个 AI 系统不再只有「一个大脑」,而是开始出现分工:海量的毫秒级判断交给便宜到像自来水一样的直觉模型,只有在真正需要向人类输出成段文字、起草复杂文档的少数节点,才唤醒那个昂贵的生成式模型。
这不是降本增效,这是 AI 基础架构从「中央集权」,走向「分布式分工」的起点。
当一个判断的成本从几美分降到万分之一美分,开发者不是把原来的 100 次判断做得更便宜了。他们开始做 10000 次以前根本不会做的判断。给每条数据库记录加一个语义过滤器,给每次工具调用加一个安全审查,给洗衣机加一个「衣服忘拿了吗」的判断。
这些不是现有工作的优化版本,而是全新的智能消耗场景。
所以,你会用 Jev 来做什么创新?
本文来自微信公众号“极客公园”(ID:geekpark),作者:宇航猿,编辑:靖宇,36氪经授权发布。