
当大语言模型在逻辑题上给出错误答案时,我们通常会下一个很快的结论:它不会做这道题。
但这个结论真的可靠吗?
想象一下:学生已经在草稿纸上写出了正确推导,交卷时却把答案栏涂错了。只看答题卡,我们会说他 “不会”;如果能同时检查草稿,就会发现问题出在最后一步的表达。
北京大学研究团队 和 易鑫(YIXIN)AI Lab 围绕大模型推理评测与内部表征展开合作,共同追问一个看似简单、却可能影响我们解读 Benchmark 结果的问题:
当模型答错一道逻辑题时,它是真的没有想出来,还是已经想到了,却没有把正确答案表达出来?
这项研究提出了一个专用于大模型的诊断视角:模型很可能已经在隐藏状态(Hidden States)中编码了正确答案,却在将其转换为最终候选分数的过程中,被输出层的系统性偏差给 “掩盖” 了。作者将这一现象命名为 “读出瓶颈”(Readout Bottleneck),并设计了一套分阶段的诊断方法来验证 “答错” 究竟是能力缺失,还是表达失真。
该工作已被自然语言处理顶级会议 EMNLP 2026 主会接收(录取率 15.4%)。
-
论文题目: Wrong Prediction, Right Answer: Recovering Evidence from Collapsed LLM Sequence Scores
-
作者: Qiyao Yan、Chenpeng Wang、Liangming Pan
-
合作单位: 北京大学、易鑫(YIXIN)YiXin-AILab
-
Arxiv 链接:https://arxiv.org/abs/2608.31068
1. 一个常被忽视的混淆:答错,真的等于不会吗?
在目前的逻辑推理评测(多选题或固定选项)中,标准流程非常统一:1)输入题干 ,2)计算每个候选答案的 Logit 分数,3)取最高分项 ,4)统计准确率。大家习惯性地将最终得分低,等同于 “模型缺乏该项推理能力”。
但作者团队指出,这里存在一个被长期混淆的因果断裂:模型最终输出错误,究竟是因为内部根本没推导出来,还是推导出来了,却在最后一步的输出映射中被 “读坏了”?
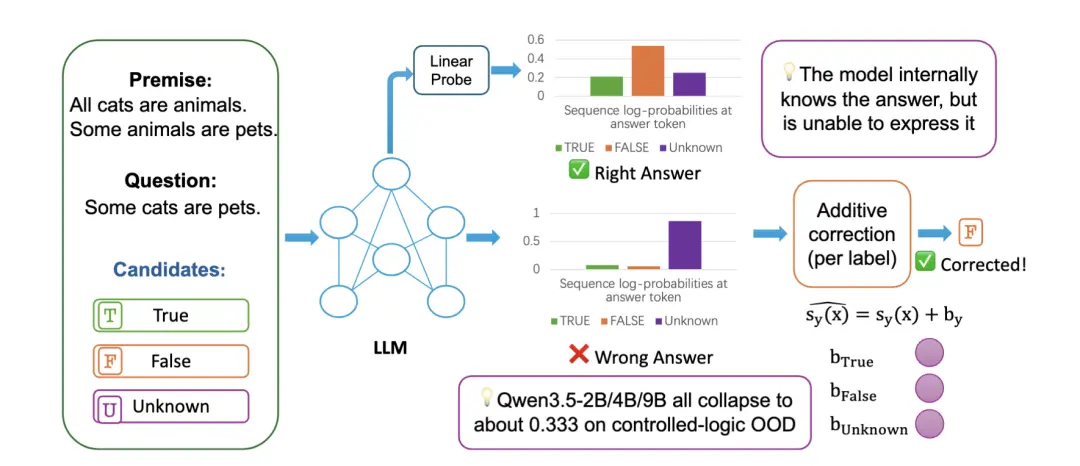
图 1:论文的三步诊断链。关键问题不是 “模型最后选了什么”,而是 “正确答案的信息在哪一步丢失了”。
为了把这两者彻底拆开,作者在不同难度梯度的测试集上(包括基础同分布的 id、考查更长推理链的 depth、以及替换了词汇表达的困难切片 lexical-OOD),对模型推理过程中的不同 “读出” 节点进行了对比:
-
隐藏状态早已 “知道” 答案:不管是在提示词刚结束时(Prompt-end probe),还是在紧接着 Answer: 标记之后的节点(Answer-slot probe),线性探针都能以极高的准确率解码出正确答案。以 Qwen3.5-9B 在最难的 lexical 切分为例,此时探针准确率高达 0.830。
-
两段式的 “表达坍塌”:然而,当这股正确的逻辑信息流经模型固有的词表矩阵(Same-position label logits)时,信号开始大幅衰减至 0.574。更致命的是,哪怕模型在预测第一个词元时(First-label-token score)还勉强保留了一丝优势,一旦将整个候选短语的对数概率进行累加(Full string score),误差就会被无限放大,准确率瞬间跌至 0.333—— 彻底沦为三分类的完全盲猜。
在 Qwen3.5 系列模型 的受控逻辑测试(Lexical-OOD)上,对比结果如下:

表1:Qwen3.5 模型不同“读出”方式的准确率对比。
当在模型输出答案标签前接入线性探针(Linear Probe)时,探针能以极高的准确率(如 Qwen3.5-9B 在 lexical-OOD 切分上达 0.830)解码出正确答案。然而,当这股信息流经词表投影,聚合成最终候选序列分数时,准确率却断崖式下跌至 0.333(等同于三分类的随机盲猜)。模型并非逻辑推导失败,而是被输出层的系统性结构偏置(如偏好 “unknown” 等安全标签)掩盖了真实判断。
更夸张的是,在原生序列打分下,Qwen3.5-9B 在 1,000 道测试题中竟有 999 道被判为了同一个标签(unknown)。这显然不是每道题都在逻辑上遭遇了独立失败,而是输出层存在一个极强的全局偏好,把样本之间的实例级逻辑差异硬生生碾平了。
甚至在未经任何指令微调的原始底座模型(Base Model)上,这一现象依然稳固存在(Qwen3.5-9B-Base 探针 87.3%,序列打分仅 36.1%)。
核心结论:模型的推理信号并未在深层消失,但从内部隐变量走向原生词表与序列累加的过程中,存在一个严重的读出瓶颈(Readout Bottleneck)。
2. 极简修正:只动 2 个参数,唤醒被 “封印” 的推理能力
如果原生序列分数真的只是一层被 “全局偏置” 扭曲的信号,那它内部是否还残留着针对具体题目的相对排序?
论文提出了一个判定逻辑:将候选分数的生成过程解构为两部分:

其中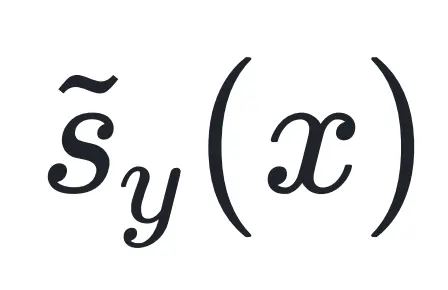 是随具体题目变化的逻辑信号,而
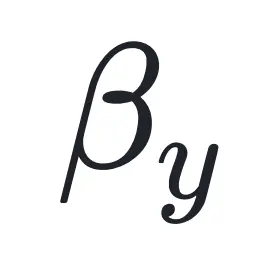 则是与标签绑定、不随样本改变的结构性偏置。当
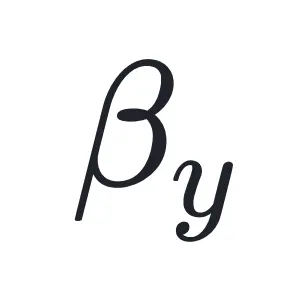 过大时,
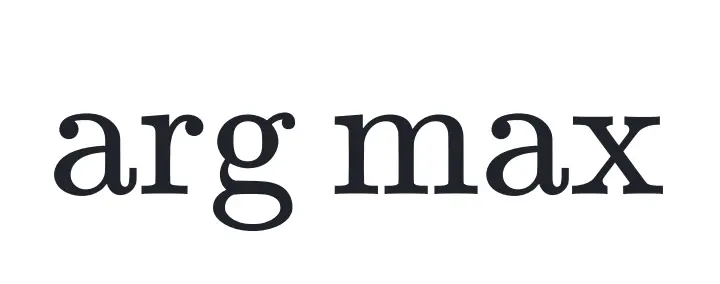 自然被全局绑架。
为了验证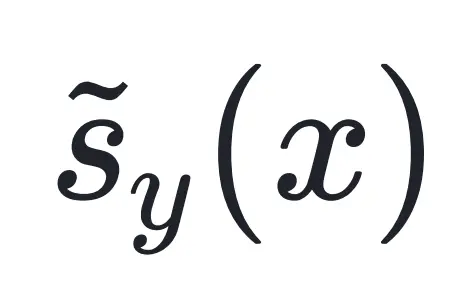 是否仍然有效,作者设计了一种极度克制的诊断干预:不对模型参数做任何改动,也不使用任何测试集标签,仅对每个候选类别增加一个全局标量偏移量
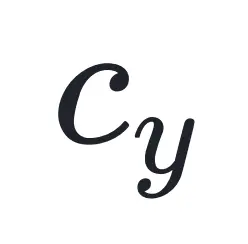 :

在三分类任务中,固定一个基准项后,自由参数仅仅剩下 2 个。这两个参数完全在无标签的上下文分数上,通过网格搜索使其预测分布贴合类别先验(如均匀分布)完成拟合,随后直接在独立的 Held-out 测试集上冻结评测。
这种干预的能力上限被死死限制住:
-
它只有 2 个参数,绝不可能学会复杂的 “输入 - 推理 - 输出” 任务映射;
-
它是全局常数平移,不可能改变同一个类别内部不同样本的相对好坏。
如果这区区两个参数能在测试集上救回大量错题,唯一的解释就是:模型给出的原始分数差值里,本来就保留着正确的相对排序证据。
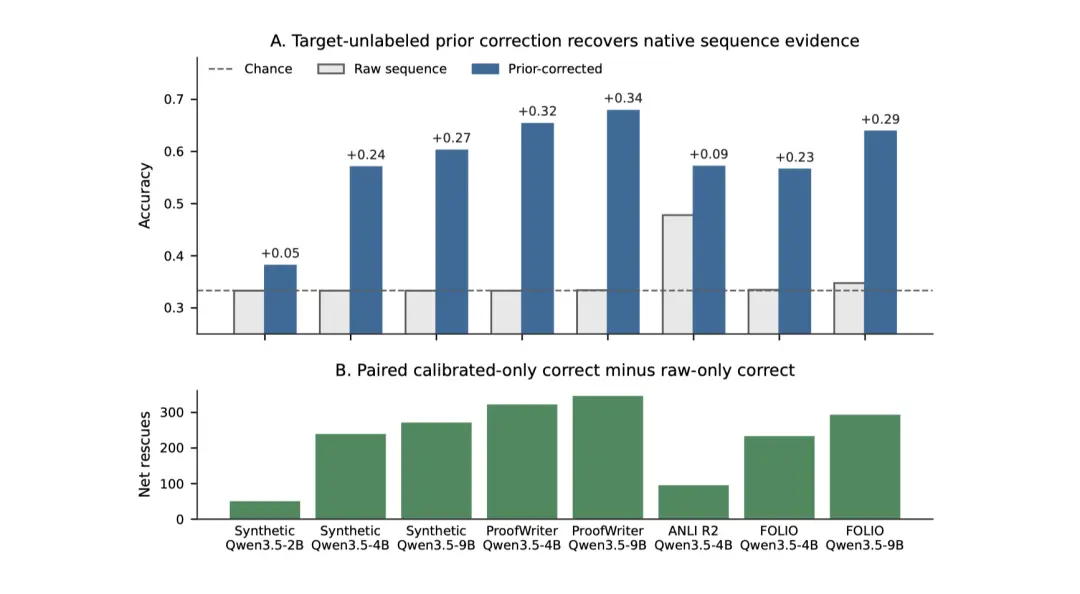
图 2:灰条为原生序列准确率(虚线为 1/3 随机线),蓝条为两参数无标签先验修正后成绩;下方绿条展示逐样本净拯救数(校准单独答对数减去原生单独答对数)。
实验在四大推理任务上展现出惊人的一致性:
-
Synthetic 逻辑任务:Qwen3.5-4B 与 9B 的准确率从 33.3% 盲猜直接拉升至 57.0% 和 60.2%,净挽救错题超过 230 道;
-
ProofWriter 自然语言演绎:模型从完全坍塌的 33.3% 暴涨至 65.3% 和 67.8%,单任务挽救了超过 320 道原本判错的题;
-
FOLIO 与 ANLI 进阶推理:即使面对高度复杂的一阶逻辑与对抗性 NLI,修正依然带来了 9 到 29 个百分点的稳健恢复。
跨模型验证同样成立:OLMo-2-1B 的准确率从 0.362 提升至 0.566,Llama-3.1-8B 从 0.333 提升至 0.477(置换检验均为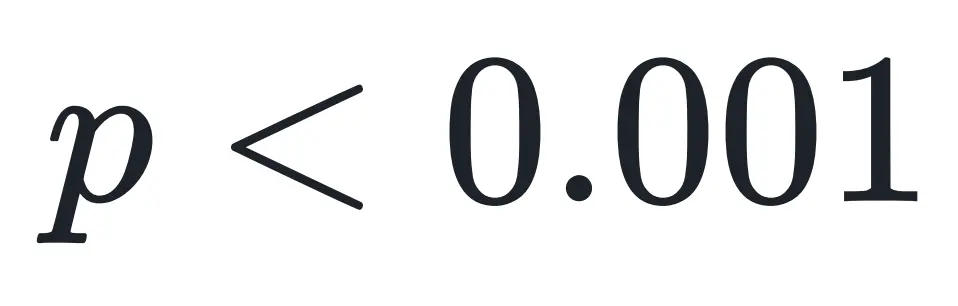 )。
更关键的是样本效率(Sample Efficiency):因为拟合的只是极低维的偏置,在 30 次随机子采样中,仅需 25 个无标签样本,Qwen3.5 就能找回绝大部分丢失的准确率,继续追加数据至 1,000 个时表现基本饱和。这彻底排除了 “修正是在暗中重新学习任务” 的假说。
3. 严格因果对照:排除 “作弊” 与 “幻觉”
面对 30 多个百分点的回弹,审慎的研究者必然会追问:这会不会只是投机取巧?比如利用了词汇重叠的浅层捷径,或者仅仅是把预测直方图强行拉平带来的运气?
作者在论文中通过两道最严苛的对照控制,封死了所有的替代解释:
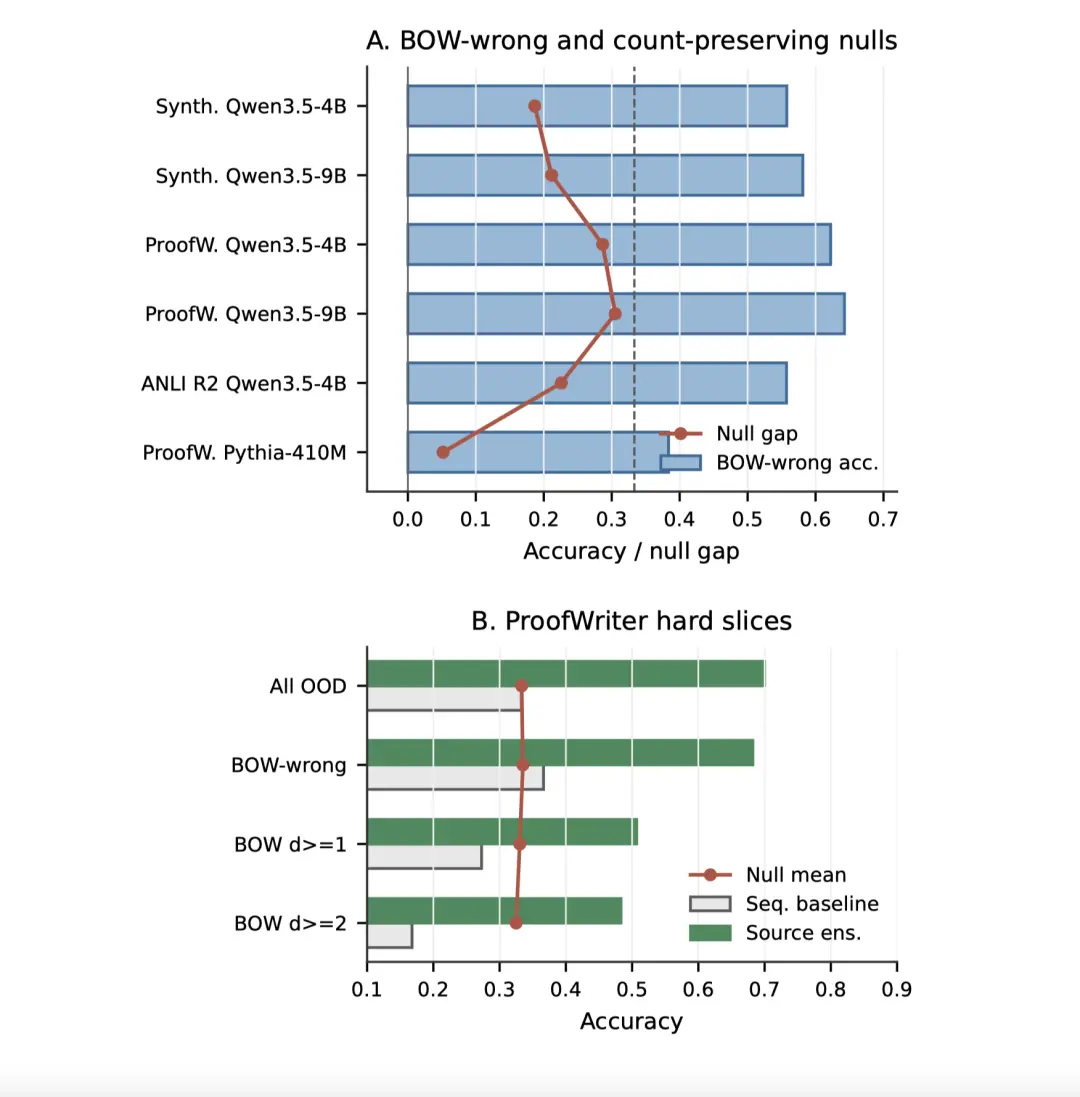
图 3:A 组针对词袋分类器(TF-IDF)失效样本的恢复情况,红点标出高出置换零假设的净差距;B 组展示 ProofWriter 随推理深度增加的切片测试。
控制一:专打浅层捷径的 TF-IDF-missed 难例切片
大模型常被质疑是 “聪明汉斯(Clever Hans)”,通过前提与假设之间的表面词汇重叠来投机猜题。 作者用词袋模型(TF-IDF)作为过滤器,将所有仅凭浅层词汇重叠就能做对的样本全部剔除,只留下纯靠词汇线索做不对的硬核难题。 在这些难例切片上,Qwen3.5-4B/9B 的修正后准确率依然稳定维持在 62.2% 和 65.1%。这证明找回来的决定是扎扎实实的语义演绎,与表面字面重叠无关。
控制二:保持标签总数的随机置换检验(Count-preserving Permutation Null)
如果方法仅仅是 “让输出 true /false/unknown 的总比例看起来更平衡”,那么即使把模型修正后的预测标签随机打乱分配,也能获得表面的准确率提升。 作者计算了置换基线(Null Baseline):Qwen3.5 在所有核心任务上的真实预测表现均显著超越了置换零分布(净超额 gap 普遍在 +0.20 到 +0.30 以上,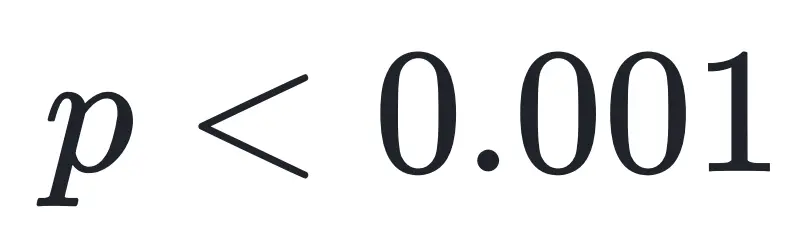 )。这证实了该方法不是简单地让模型输出答案全局均衡,而是真正地纠正了模型错误分布的表达。
不过该方法仍然存在一些局限,论文明确列出了三类失效的边界场景:
-
模型内部压根没有形成有效表征:Pythia 系列(410M/12B)在相同流程下未能通过置换检验(
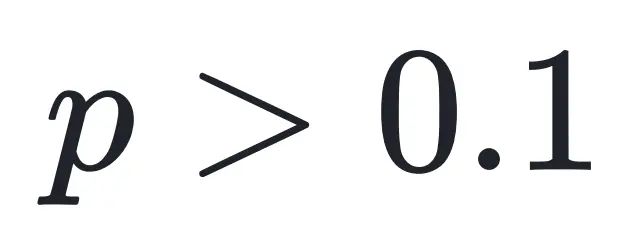 ),证明它在内部就没做对,不存在被掩盖的排序;
-
基线表现已接近上限:当模型原生精度本身很高时,可供发掘的未被释放信号微乎其微;
-
严重失衡的非受控环境:诊断严重依赖对类别先验的合理假设,在极端长尾或完全未知的任务中,先验本身的估计仍是开放课题。
4. 结论:别让最后一个结果 Token,轻易否定模型的全部推理
这项研究为社区审视 Benchmark 评测方式提供了一个新的视角:大模型的 “内部推理能力” 与 “外部表达通路” 从来都不是同一件事。当评测强行将多步逻辑压缩成单个分类词(Token)的生成打分时,静态线性层(Unembedding)的几何错位与序列打分的累加偏差,极易成为掩盖模型真实智能的 “读出瓶颈”。
这也为思维链(Chain-of-Thought)为什么在长逻辑上更有效提供了一个新的机理注解:让模型通过多步 Token 逐步吐出思考,本质上是将单步输出层沉重的读出负担分散到了序列的演化路径中,从而有效绕开了瓶颈扼杀。
在大模型评测榜单日益泛滥、大家对分数分毫必争的今天,这项工作给出了一个更严谨的视角: 当看到模型在一个任务上给出接近盲猜的分数时,不要急着判定它 “不会做”—— 先看一眼它的隐藏状态。也许模型早就在 “草稿纸” 上算对了全部逻辑,只是最后在 “涂答题卡” 时,被输出层的一点偏置带偏了而已。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com