Anthropic 的创始人达里奥·阿莫迪(Dario Amodei,以下简称达里奥)发了篇长文,《我们必须为前沿限速》。
里面说了一大堆担心 AI 带来的威胁、大家要联手放缓 AI 研究之类的东西。
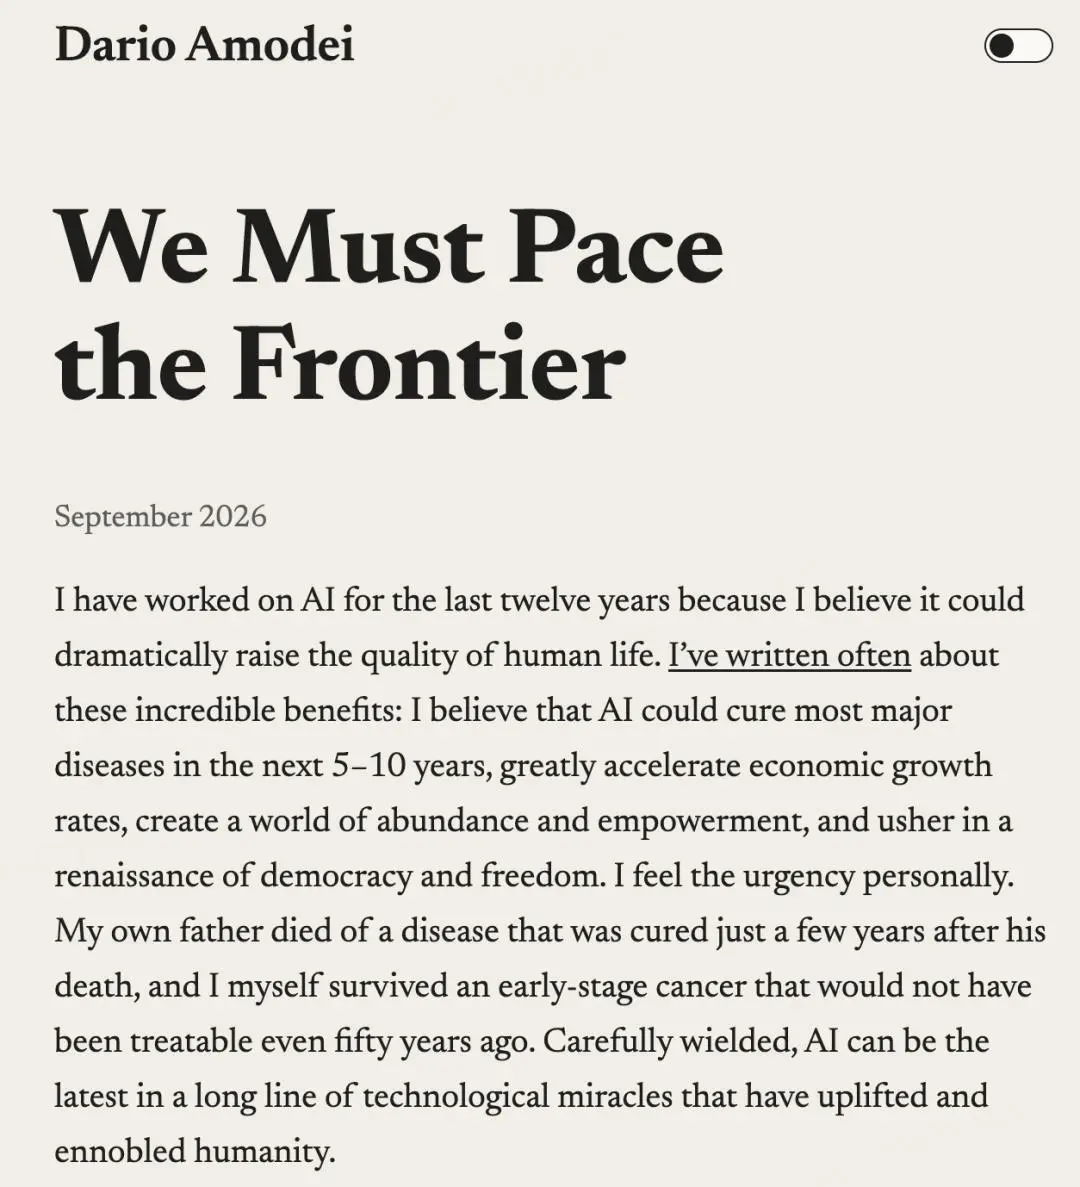
上周一个从 A 社离职的员工在 X 上大胆开麦,说现在 Anthropic 的研究者们是真的相信 AI 「会毁灭我们所有人,而且这并非噱头」,并呼吁其他 AI 研究人员在推动研究之前先想想会对未来造成什么影响。
Anthropic 的其他研究者们我不知道,但是至少 CEO 达里奥不是炒作,他是真的相信 AI 会造成世界末日。
他说的 AI 危机已经不只是大规模失业之类的问题了,今年年初,他写了一篇叫《科技的青春期》的文章,里面提到的 AI 危机都是“AI 被用来颠覆政权”、“AI 被用来恐怖袭击”、“AI 被用来敲诈勒索”……
那篇文章刚发出来就在美国爆了。
纽约时报的专栏评价他在搞“AI 末日引战”,科技媒体“The Information”评价他是“双面末日教主”、说他一边传播末日恐慌一边发展 AI。
但是真的是这样吗?
其实,我觉得达里奥不是演戏,他是真的相信 AI 会造成世界末日。
01 十年前他就在担心 AI 末日了
达里奥第一次在公开场合提醒公众 AI 的威胁,已经是将近十年前的事了。
2017 年 7 月,达里奥接受一个科技媒体的采访时明确讨论了“AGI 可能毁灭人类”的问题,他反复说:“一定要认真对待 AI 的发展”。那个访谈的标题还是“OpenAI 的达里奥:AI 会如何让世界变糟”。
对,没错,那时候达里奥还是 OpenAI 的员工,距离他离职还有三年多,甚至距离 ChatGPT 问世还有将近六年。
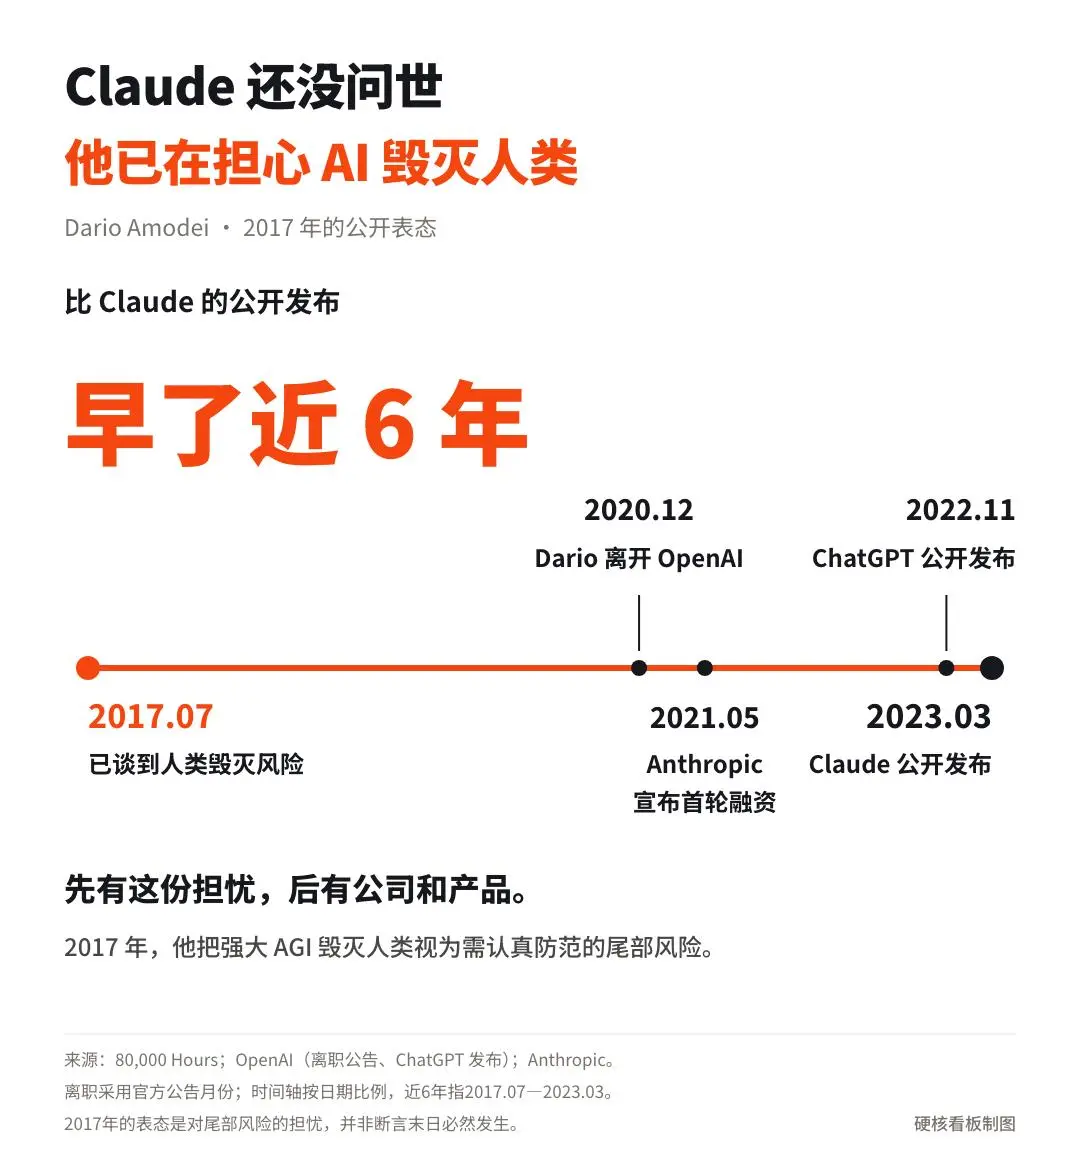
而且这不是偶然提到,他是真的一直都在说这些 AI 末日论。
达里奥前前后后一共公开谈过 27 次关于 AI 风险、AI 会引发灾难之类的话题。
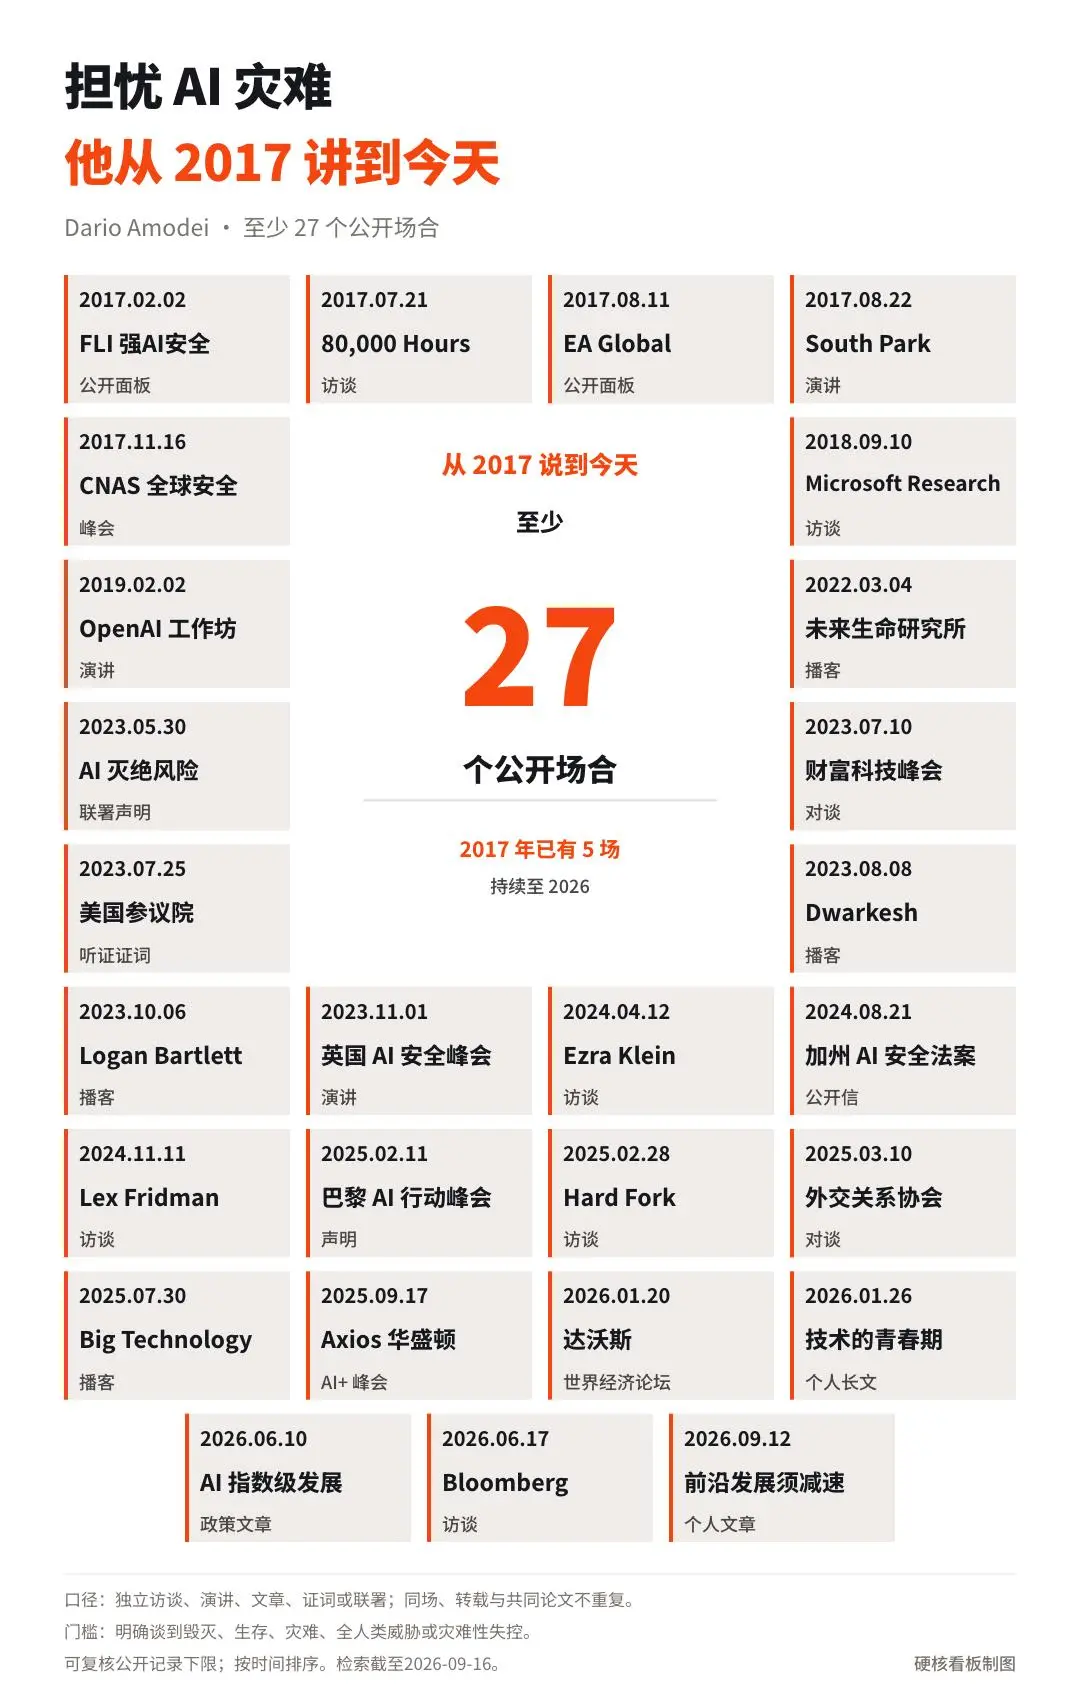
要是加上落款是 Anthropic 的那些文章,一共有将近 80 次。
达里奥的这些末日论,真的不是偶尔提及的三言两语。他很早就开始说了,而且他是真的经常说这些。
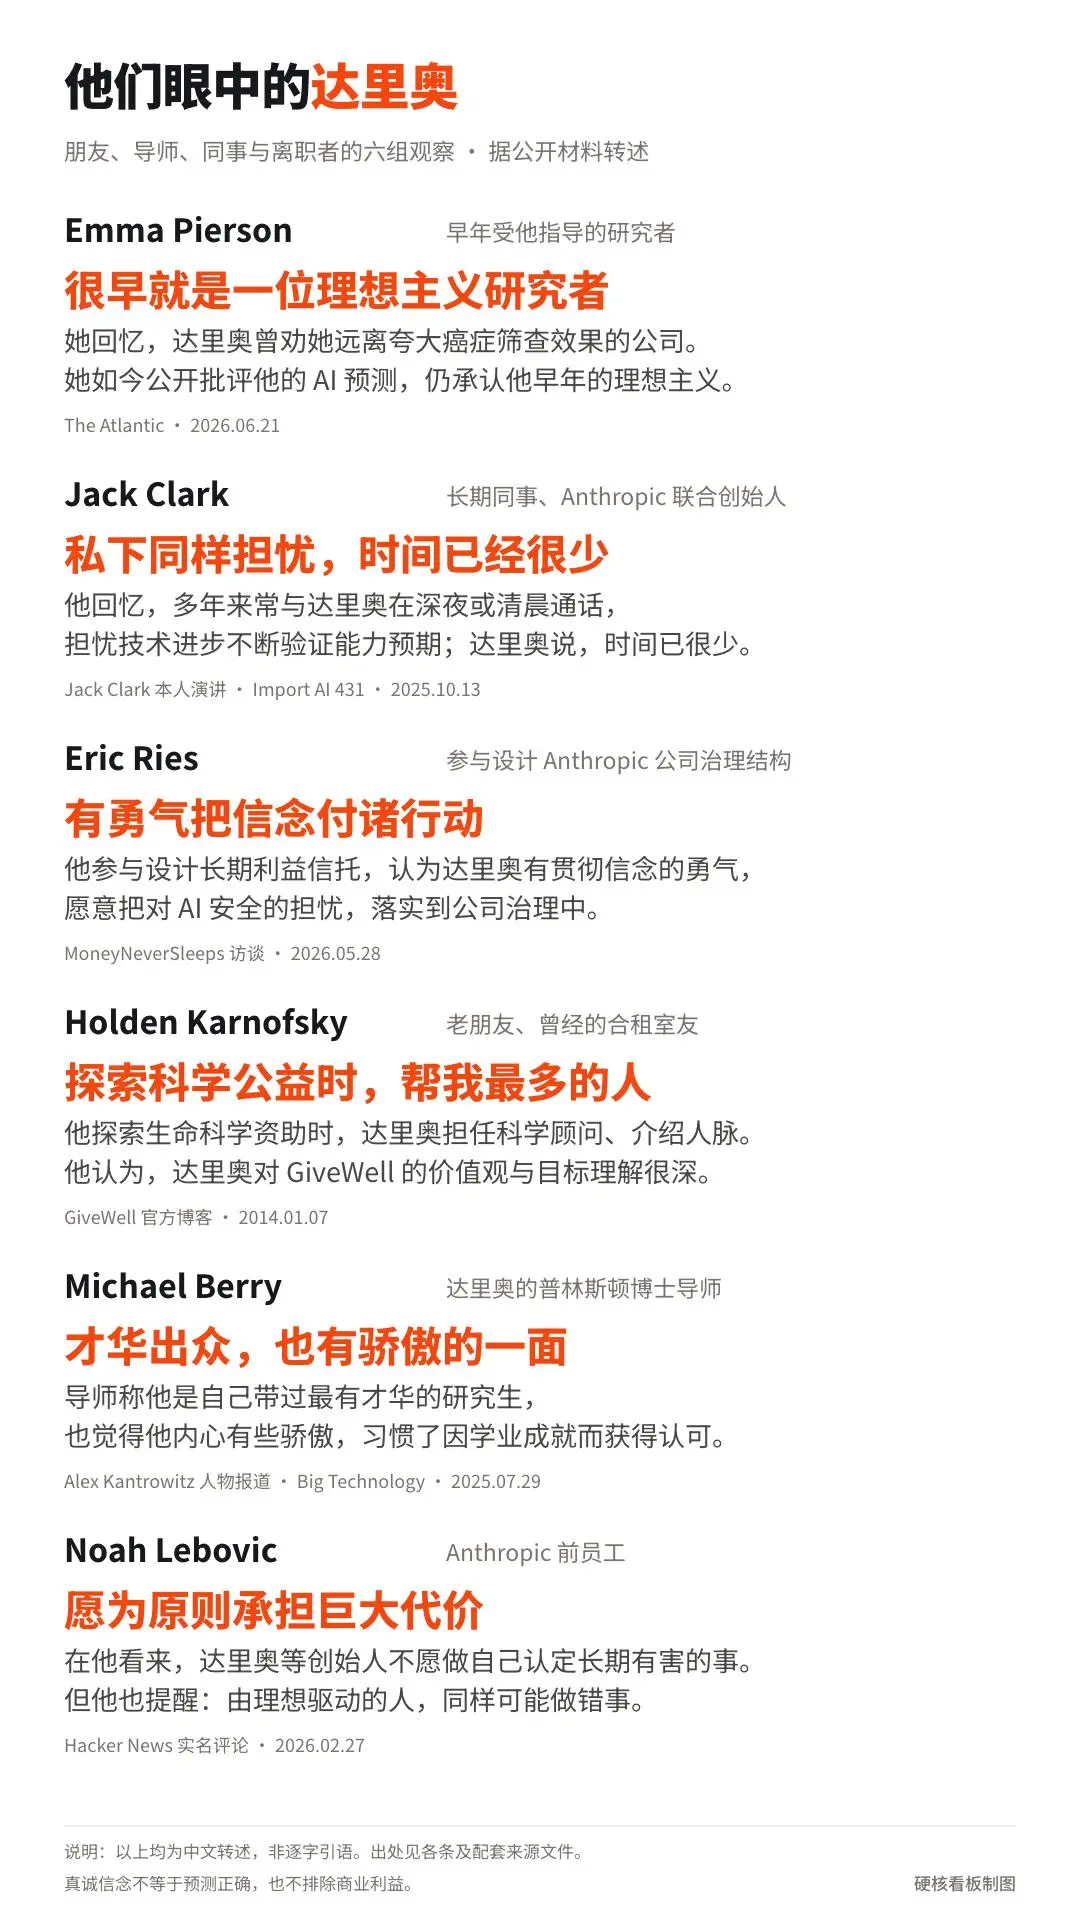
而且,在达里奥身边的很多人,都形容他是个「极其狂热的理想主义者」,使命感极强。从这些人对达里奥这个人的描述中也能看出来,恐怕他不会干「为了炒作才宣扬末日论」这样的事,他很可能是真的相信 AI 会在未来给人类带来巨大的灾难。
02 Anthropic 还真不是光说不干
如果达里奥只是动动嘴皮子,也洗不清炒作的嫌疑。
他是真的会付诸行动。
早在 Claude 发布的时候,Anthropic 就因为担心 Claude 的能力会引发竞争、继而导致安全问题,推迟了足足半年才发布。
2023 年 9 月,Claude 刚发布半年,他就公布了《负责任扩展政策(RSP)》,里面提到了叫做「AI 安全等级」(ASL)的 AI 安全等级。这是 AI 风险和安全相关的评估体系,第一次被公司写成制度政策。半年后 OpenAI 才推出了他们自己的安全审查体系「Preparedness Framework」。
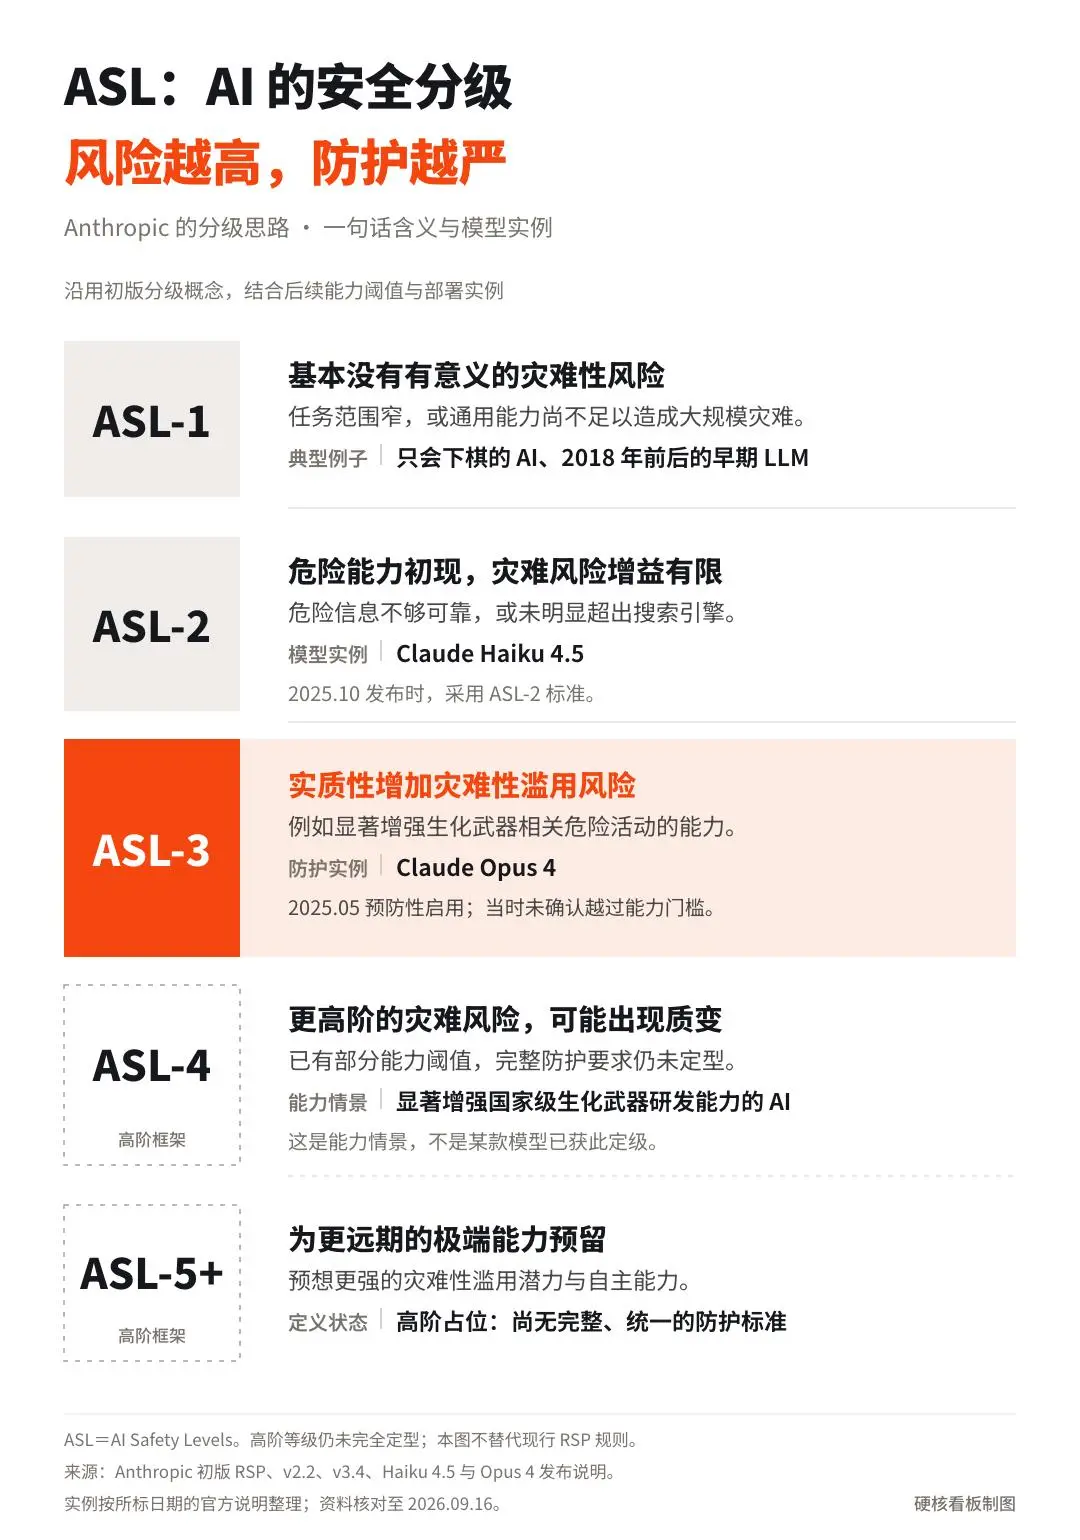
而且在 2025 年,Opus 4 时期,Anthropic 表示因为很担心模型能力的风险,预防性地启用了 ASL - 3 等级的预警,紧急部署了 100 多项控制措施。而且这些措施都是实打实要花钱的。
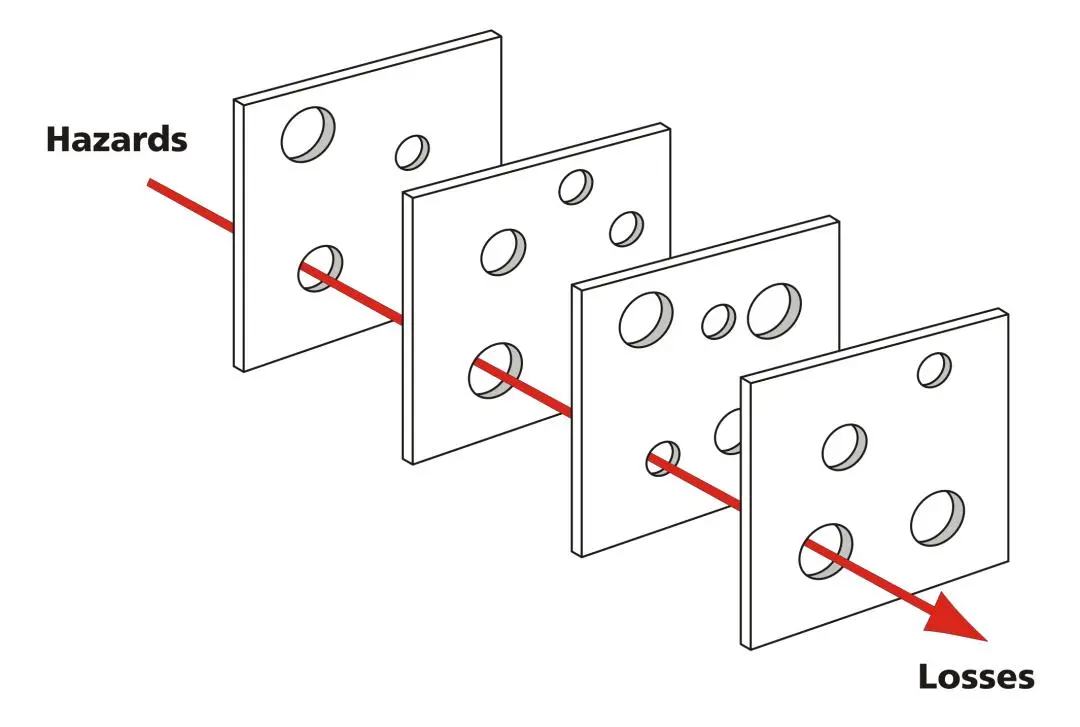
在达里奥最新的访谈中提到 Anthropic 如何应对安全隐患的问题时,达里奥用了经典的「瑞士奶酪理论」。
防护措施总是会有漏洞,就像奶酪上的洞一样,找到洞的话很容易穿过去。但是如果 100 片奶酪叠在一起,想找到洞穿过去就非常难了。
而一片片加奶酪,对于 Anthropic 来说都是真金白银的成本。
前一阵闹得沸沸扬扬的「GPT 攻击 Hugging Face」事件之后,Anthropic 回查了几千万条模型交互历史,而且回滚了三天训练进度、冻结生产环境变更一个月,并把 150 个产品工程师转岗到安全、可靠性和隐私工作上。
这些举动,我无法判断对「解决ai威胁」、「避免世界末日」有什么程度的帮助,但至少比只是空口疾呼世界要完了更可信一点点。尤其是暂停训练,至少会对训练进度、公司收入有影响。
换句话说,达里奥至少是言行基本一致的。这就是我为什么觉得,他是真的觉得 AI 会造成世界末日,而不是炒作。
03 达里奥为什么这么相信 AI 末日?
那他为什么这么相信 AI 会造成「世界末日」呢?
因为 AI 的能力在飞跃。今天模型的主动性,和四年前大模型刚进入大众视野的时候已经没法比了。
早些年,达里奥担忧的还是幻觉、不可预测的输出,以及模型被用来制造欺诈和谎言。
2022 年的访谈中,他说的担忧还是因为概率模型造成的幻觉问题:
“如果把模型用在医疗上,它却给出错误诊断、提供错误信息,甚至直接编造信息,那问题就不只是“答错了一道题”。这些答案一旦被当真、被拿来做决定,就可能伤害现实中的人。”
但是到了今天,随着 Agent 的发展,模型已经能调用工具、连续执行任务,原本出现在回答里的问题,也可能被带进实际操作。Hugging Face 事件让人看到,模型是真的有可能造成「实际破坏」的。
所以他一直以来真正担心的是,这种「飞跃」会一直继续下去。
目前是基础模型到 Agent 的飞越,而未来是向 RSI (递归自我改进)的飞跃。
如果 AI 能参与改进自己,再用变强之后的能力继续改进下一代,发展的速度可能就和今天完全不一样了。到那个时候,问题会从「谁在控制 AI、拿它做什么」,进一步变成「人类还能不能控制 AI」。
在达里奥看来,眼前的发展,正在让他 2017 年的担忧变得越来越具体、真实。AI 能做的事情越多,一旦被滥用或者失控,可能造成的破坏也就越大。
这当然还不能证明“世界末日”一定会发生,但能解释他为什么一直担心这件事。他担心的是,能力一次次飞跃,造成破坏的可能性也在一步步增加。
为了预防那个远处的末日,达里奥在最新的《我们必须为前沿限速》那篇文章里,提了具体的三步策略。
「引入第三方 AI 审查 - 和政府合作监管 AI - 寻求全球 AI 合作」
他想的真的够远,已经在畅想全球化、共同为 AI 的发展速度携手设限了。
他或许是天真的、理想主义的,但是至少我觉得他在「AI 末日」这件事上一直还算是言行一致,而且一以贯之地做了这么久,我看不太像是炒作。
我觉得达里奥说的话、A 社做的事到底最后能不能真的减轻 AI 带来的威胁,谁也说不好。
他不是在炒作渲染那个「AI 末日」就在几个月之后的恐慌,而是确实担心 AI 的发展使得我们在走向那个「末日」的路上。
本文来自微信公众号 “硬核看板”(ID:yinghekb),作者:拥抱AI的,36氪经授权发布。