今年,用AI自我改进AI,几乎成了海内外头部实验室的共识。
近一年来,OpenAI创始成员Andrej Karpathy、前Meta FAIR研究总监田渊栋、前DeepMind首席科学家Jeff Dean都相继加入RSI(Recursive Self-Improvement,递归自进化)创业的热潮。
发生在RSI身上的,几乎是一个和世界模型高度相似的故事——即使是最先进的实验室,也没有探索出关于递归自进化的突破性成果,技术的不确定性,很快被宏大的叙事与火热的资本市场淹没。田渊栋就是一个典型的例子,今年5月,他所在的创业公司Recursive Superintelligence在还没有交出成果的时间点上,却已官宣完成6.5亿美元融资,估值推高至46.5亿美元。
这股热潮也蔓延至国内。今年1月,就读于哈佛和MIT联合培养项目、即将博士毕业的陈勇超,正站在职业选择的岔路口:一边是DeepMind的工作邀约,以及多家专注做AI自动科研的海外初创公司抛来的联创橄榄枝;另一边,是他等了两年的创业Timing,恰好在此刻到来。
他想做的是,训一个能自进化的通用模型,让它在一套能自进化的Harness之上,独立完成人类科学家在做的研究,包括构思想法、检索文献、跑实验。
经过一系列的考量,他选择了后者,回国创立了超衍智能(Apex Intelligence),专注做自主进化的基模研发,并同步入职清华大学。
27岁的陈勇超,成为了清华大学人工智能学院有史以来最年轻的助理教授,他在7月正式官宣创立的超衍智能,也在短短两个月的时间内完成了两轮亿元级融资。
《智能涌现》获悉, 近日,超衍智能已完成近4亿人民币天使轮及天使+轮融资。天使轮由IDG资本、星连资本、晶泰科技联合领投,德迅资本、无限基金、初心资本、云岫资本跟投,汇聚了头部美元基金、产业资本及市场化投资机构。天使+轮则由北京、深圳、上海三地头部国资——中关村科学城基金、深创投、上海未来产业基金联合领投。
本轮融资将重点用于基础模型与算力基础设施的构建、递归自进化技术的研发投入,以及核心团队的扩张。
这是一支由Researchers主导的创业团队,超衍智能创始人陈勇超曾在Google DeepMind、Microsoft、IBM等海外实验室做大模型相关研究,团队核心成员来自字节、Kimi、智谱等头部大模型厂商,有一线模型研发经历。
不同于做Agent层的RSI,超衍不聚焦于做AI for Science的Harness和应用,而是探索基模层的递归自进化能力,让每一次研究任务生成的轨迹变成训练数据,用于改进模型,并进一步攻克更难的问题。
在超衍内部,这套逻辑被概括为“Research is the engine of RSI”,即研究是递归自我改进的引擎。它的最终目标,是用一套递归智能系统连接数字世界与物理世界,将统一的能力拓展至AI、数学、物理、芯片设计、机器人、工业制造、化学、生物等各个领域。
“Coding平权之后,下一波会是Research的平权。”在陈勇超看来,AI的自进化,正在成为现实。
他手上的第一个有力证据,来自今年5月,他们让公司的自进化AI System自主产出了34篇论文,结果相当惊喜,这些论文提交到ACL Rolling Review(ACL系列会议的统一审稿平台)后,有11篇拿到了3分以上,这是一个不低于博士水准的初审分,其中,还有2篇论文的分数超过了99%的人类研究员。
“很多想法都挺让人眼前一亮的,有些论文几乎达到了博士生水平,这在我们的意料之外,但也在情理之中,因为这个时刻迟早都会到来。”陈勇超说。
论文之外,从AI自主进行AI方向的研究,到在数学等基础科学领域的探索实验,超衍的AI系统已在多个高难度研究领域完成初步验证。目前,公司内部已沉淀数万条高质量研究轨迹(Research Trajectories),涵盖专家轨迹、合成轨迹和AI自主生成的研究轨迹。
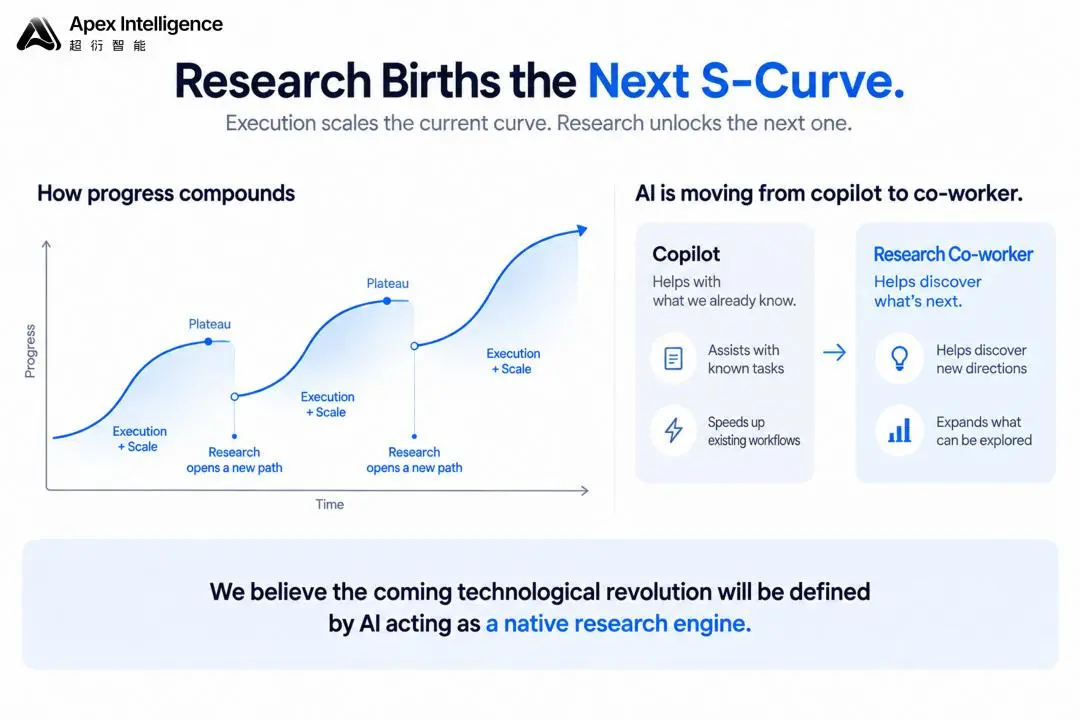
研究是递归自我改进的引擎,图源:企业
如果要把智能的演进放在一个坐标轴上,陈勇超认为,它不是平滑上升的,而是沿着S型曲线,突破一个瓶颈、快速爬升、然后平缓,再等待下一个瓶颈。现阶段,我们正处在上一个属于Scaling Law拐点的平稳阶段,正在等待新拐点的出现,以及下一个智能快速爆发的时刻。
陈勇超对这个拐点即将发生坚信不疑,“时代不可能等你,这和两年前不做大模型、一年前不做具身智能的情况是一样的,RSI在现在就是最好的创业时间点。”
关于回国创业、选择RSI方向以及对智能演进的思考,我们带着一系列问题,来到了清华大学人工智能学院的办公室,与他展开了交流,以下是我们和陈勇超的对话实录,略经摘编:
模型的稳定性和创新性,是对抗的
为什么今年RSI突然爆发了?
陈勇超:很多人认为是模型能力到了瓶颈期,需要探索新路径,我觉得这是次要原因。最主要原因是,技术的转折点已经来临,模型已经强到一定程度,能够做很多人类研究员做的研究了。这也正是我们探索的方向,训下一代模型,让它能达到甚至超越人类研究员的水平。
用简单的话解释,自进化的模型和现在的大模型有什么区别?
陈勇超:现在的大模型是求稳的模型,给大众用、保守的、不想让它犯错的模型。比如,问它100个问题,它能回答出95个,剩下答不出来的问题努力让它减少幻觉,或者让它直接回答不知道。
但自进化的模型是注重创新性的模型,它对稳定性要求不高。比如,你问它一个问题,它答不出来,但我们期待它能提出100种不同方法解决这个问题,其中99种错得再离谱都没关系,只要一种对就行。也就是说,探索过程中要允许大量方法失败,但只要其中一种被证明有效,系统就能识别它、保留下来,并且将这次成功转化为未来可以复用的能力。
模型创新性和求稳性很多时候不可兼得,模型过于求稳保守,其创新性就会弱。有的时候我们甚至发现,模型通用的评测结果越好,创新性越差。
要实现模型的自进化,关键的技术卡点在什么地方?
陈勇超:第一是模型提出天马行空想法的能力;第二是自主执行能力;第三是验证能力。目前,模型能否提出好想法,筛选出好想法后自主执行下去并做好验证,是特别大的卡点。
这些卡点可以通过什么方式来解决?
陈勇超:模型的训练方法以及模型架构,尤其是上层架构,都要做一些调整,数据也有很大变化。比如,用一些对抗性的训练方法,让一个模型扮演不同的角色:既能提出好的想法,也能自行评估,判断这个想法在合理性、创新性上表现如何。通过迭代式的自我改进方法,让想法越来越好、创意水平越来越高。
为什么先从科研场景先尝试模型自进化能力的落地?
陈勇超:科研场景对聪明大脑的需求最为迫切。自进化本身是在追求智能上限,也就是对标甚至超越人类研究员。它通常会瞄准那些处于智能上限、最需要创新性的场景。
AI for Science、AI Scientist、Auto-research和Recursive Self-improvement,这几个词之间是什么关系,有重叠吗?
陈勇超:在我看来,RSI、Auto-research和AI Scientist虽然不是字面意义上的同义词,但本质上指向同一个目标,就是构建能够自主开展研究、并在研究过程中持续提升自身能力的通用研究智能。AI Scientist描述的是这种系统扮演的角色,Auto-research描述的是它自主完成研究的过程,RSI描述的则是它根据研究结果不断改进自身的机制。
AI for Science和它们不在同一个概念层次。AI for Science描述的是AI被应用在哪里,即利用AI解决科学问题;它可以是一个科研工具、一个垂直领域模型,也可以是一个完整的自主研究系统,但并不必然具备自主研究和自我改进能力。
尽管Auto-research和AI Scientist出现得更早,但很多做这两个方向的人把这个概念做窄了,Auto-research并不只是搭一个Agent写论文,AI Scientist也并不只是训练一个垂直领域的小模型。它们真正要解决的问题是,训练出一个通用模型来超越人类研究员,让AI成为人类员的Coworker。
RSI可预见的上限是怎么样的,能达到什么样的水平?
陈勇超:这取决于它最终能成为人类哪个level的研究员,这个很难讲它最终能到清华等顶尖高校博士生水准,还是牛顿、爱因斯坦水准。
智能爆发式增长可能会出现在什么时候?
陈勇超:我觉得会有一个拐点,可能会发生于模型在某些环节的效率比人高,或者创新能力跟人差不多的时候。它是按瓶颈和阶段推进的,某段时间一旦突破了一个瓶颈,就会呈S型曲线上升,先快速发展,之后逐渐平缓,那时你就会开始等待下一个能突破的瓶颈。
现在智能处于什么阶段?
陈勇超:第一个S型曲线是Scaling Law,现在正处于第一个S型曲线接近饱和的阶段。现阶段模型的迭代,其能力进步已经没那么快了,已经到了S型的上端。RSI可能是下一个S型,也可能是帮助发现许许多多S型曲线突破瓶颈的方法论。
像人类科学家一样做研究
从整体来看,你们现在在做的事情有哪些?
陈勇超:我们做了一个做自动化科研的AI System,让它来做AI for AI、AI for Math,以及各个学科。同时,我们也在训练自己的大模型、建立能够评价大模型在研究领域能力的benchmark。
这个自进化AI System独立完成一个科研项目,其端到端的过程是怎么样的?有没有具体的案例?
陈勇超:这跟人类做研究很像,并且,它像人类科学家一样“全栈”,能自己动手做实验:自己构思想法、做实验、连GPU、搭建环境、训练模型,最后根据实验结果改进方法,并把成果总结成报告、代码仓库、产品或论文。
比如,它现在能帮数学家发现数学上的重大突破、证明定理;也能做AI领域的事,自己优化AI训练里的内核、数据分布、算子;还能做机器人VLA的数据仿真与VLA架构改进。
在这个系统中做一个项目的研究,周期一般是多长?相比人类做研究,它的速度能快多少?
陈勇超:这取决于研究难度,难度比较大的项目,AI可能要做两三周,但相比人类已经非常快了,人类的话可能要做好几个月甚至一年。
这个产品已经上线了吗?
陈勇超:最近已经上线了,正在小范围内测中。
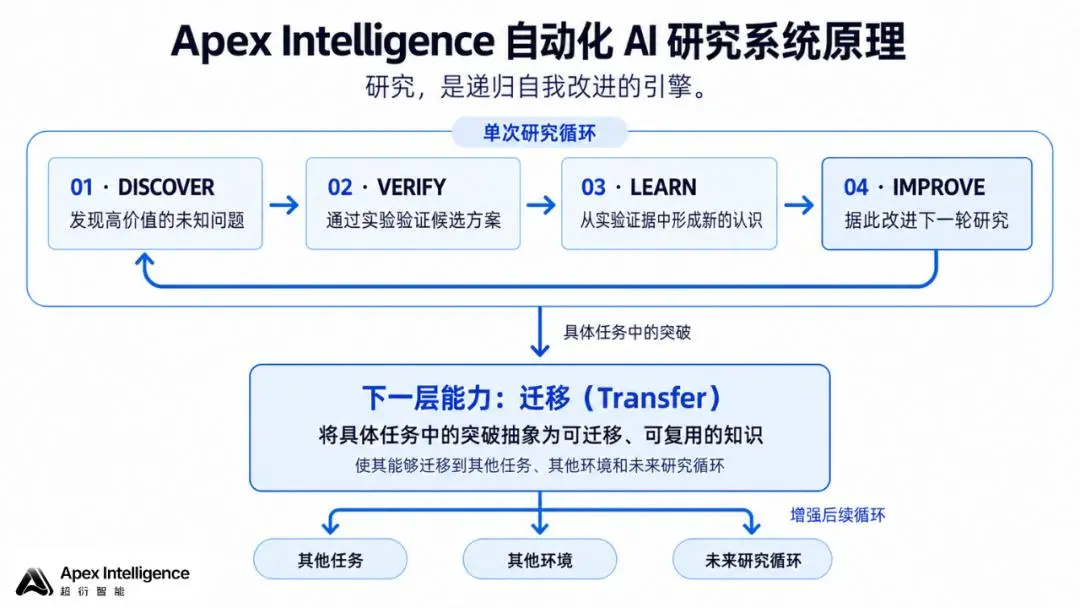
自动化AI研究系统原理,图源:企业
关于你们现在正在训的模型,可以展开讲讲吗?
陈勇超:首先,这个模型肯定是个大参数规模的模型。
它跟上一代模型很大的区别是,我们注重创新性和研究能力。它可能在一些通用能力上,如编程、数学比闭源SOTA模型差一些,但在完整的研究能力上会显著更强���
你们是从头开始训模型吗?
陈勇超:我们现在还是基于开源模型做中训练和后训练,做预训练还需要更多的资金储备。
现在你们的模型能达到什么效果?
陈勇超:我们自己看下来,有的方面比较惊艳,比如在数据自进化、Harness自进化上,但目前只能做较小的优化,想要在创新性上做很大的突破还比较难。
我们想先训一个通用的模型,它能做很多领域的研究,比如AI for AI、数学、机器人、芯片设计、量子。其中,通用模型的很多数据会包含各个领域,之后基于通用模型做微调,它也能在垂直场景中快速落地。
为什么先做通用模型,再慢慢做各种垂直场景?
陈勇超:很多领域的创新来源于毫不相关领域的启发,如果你只用垂类领域的数据训模型,它可能在局部任务上越来越强,但整体智能反而会下降,也就是我们常说的“灾难性遗忘”。
比如,我想让它做AI for大模型,让它所有的训练数据、研究轨迹,全都来自AI自己训大模型的领域。结果你会发现,它就可能逐渐过拟合这一分布,遗忘原本具备的数学、物理、化学乃至常识推理能力。如果它连常理都能忘掉,智力就会退化,它可能越来越擅长重复已有的大模型研发范式,却越来越难跳出局部最优,产生真正具有突破性的新方法。
你们最近还发了一个Benchmark,叫ASI Bench。
陈勇超:是的,这是一个评价模型探索能力和研究能力的Benchmark。ASI和AGI的最大区别是,ASI能探索模型提高智能上限、探索世界未知知识。现在还没有一个很好的Benchmark来评价模型的探索能力和研究能力,所以我们做了这个。
和RSI直接相关的数据非常少,你们如何突破呢?
陈勇超:数据是一个非常核心的问题。无论是研究类数据,还是递归数据、Auto-research数据,这些都和大模型的数据不同,它需要的是一条完整的研究轨迹数据。
这种研究轨迹非常难获得,因为它都散失在研究过程中了。大家最终留下的往往只是报告、产品、论文,那只是结果;而中间试错、成功与失败的过程轨迹,是根本没有保留下来的。
不仅如此,最顶尖的研究员、人类科学家那些“灵光一现”的时刻,很难被数字化地记录下来。比如王虹证明挂谷猜想,基本就是今天想一些、睡一觉,明天再想一些、再睡一觉,想要记录下整条思维链非常难。我们也在做这方面的探索,尝试把它复刻出来。
这么说,让AI改进AI自身,其实也是在模仿人类自我改进的过程。
陈勇超:对,最聪明的人往往都会自我进化、自我迭代,通过与外部反馈、与自己、与世界互动,来不断提升自己。我们要模仿的,就是这个过程。
一条研究轨迹包含很多内容:怎么构思想法、处理信息、搜集信息、执行实验,以及如何根据实验结果来调整下一步计划。
关于把研究轨迹数字化,你们做了哪些探索?
陈勇超:我们在构建领域专家生态,邀请各领域专家一起合作,请他们尽可能复现他们的研究轨迹,并用AI可以理解的方式无信号损失的记录下来。目前行业里基本还没有这一类完整研究轨迹的数据。我们目前已有的数据包括:与专家合作构建的数据、AI合成数据、以及用户自愿选择分享的产品使用数据。
训一个模型需要多少量级数据?
陈勇超:这个说不好,数量上很难用“多少T”来衡量,因为一条数据本身就包含很多步骤、很多轮交互。更合理的衡量方式,是按项目数量,或按轨迹的数量与长短来评估。
只做Harness层的商业化,很容易被模型吞掉
你从2月份做RSI到现在差不多半年了,从当时非常坚定地入场,到现在为止,你的体感怎么样?
陈勇超:不管在技术上还是资本市场上,当时的想法都得到了验证。
我的判断依然很坚定,第一代大模型(如ChatGPT)替代白领,具身智能替代蓝领,而ASI将替代人类科学家,也就是那些拥有博士学位、“最贵也最聪明”的一批人。
你们在商业化上有什么思考?
陈勇超:Harness层很容易被模型本身吞掉。只做Harness层的商业化,即只提供一套能自动科研的系统,其上限非常明显。因为模型训练到足够好之后,它可以自己优化自己的Harness。
我们团队最初把Harness自进化和模型进化放在一起做,很明显发现,Harness自进化做到一定程度以后就无法更进一步了。
目前你们的自进化AI System的商业化还没有起步,感觉你们并不急于商业化?
陈勇超:从上一代模型中我们就可以看出,一开始过多考虑商业化会很拖累模型训练的研发,考虑的越多,精力越被分散。我们希望更聚焦,把大量的精力和人力投入在我们研究型基础大模型训练中。
你们设想的商业模式是怎么样的?
陈勇超:我们本质上还是个基础模型公司,因此我们的商业模式本质上还是卖Token,只是Token的形式可能会是API、可能会是一个类似Claude Code一样的半成品、也可能是一个以解决方案呈现的Token集合。便于大家更好的理解,做个类比,Claude Code是Vibe Coding,我们的自进化AI系统是Vibe Research,卖模型以及Harness,让用户可以基于这个系统做各种研究。
今年你们有什么目标吗?
陈勇超:我们的自进化AI系统会上线,顺利的话,年底或明年年初会发第一版模型,这个模型在研究方面会全球领先,同时,在某些高价值领域实现落地。
这个模型会开源吗?
陈勇超:可能会,还没有最终确定。
你之前说可能还会推出其他产品,他们会是什么样的呢?
陈勇超:我们现在的产品基本有两类,跟ChatGPT类似:一类是aPaaS(低代码平台),另一类是像Claude Code这样的CLI(命令行)端。其中,第一类正在推向更多人使用,第二类可能要等模型出来之后才会上线。
智能超过人类的时刻,早晚会到来
你是什么时候发现这一代模型已经能达到人类研究员的水平了?
陈勇超:今年5月份,我们有一天突然发现,我们搭的自进化AI System生成的一些想法还挺让人眼前一亮的,生成的论文差不多能达到清华博士的水准了。比如,当时AI提出了一个挺有意思的想法:基于VLM来训练VLA,和自己端到端从头训练,两者是不一样的,在最后的编码器和解码器空间上,在特征上会产生很大的差异。
当时我们让这一系统生成了三十四篇论文,提交到了ACL Rolling Review(ACL系列会议的统一审稿平台)中,其中有11篇拿到了≥3分的初审分,这个分数意味着,这些论文可能会被Findings(ACL的论文集)接收,也可能被收录进主会。其中,我们还有两篇论文的分数,超过了99%人类研究者。
这个结果在你看来是意料之中,还是意料之外?
陈勇超:拿到结果时我非常意外,但意料之中的是,这个时刻早晚会到来。
目前有像你们一样拿到实质性结果的公司吗?
陈勇超:在ACL Rolling Review上拿到这么高分的,全球范围内只有我们一家。
你之前有提到,利用你们的自进化AI System在数学领域改进了一项沿用十余年的结论,这具体是什么?
陈勇超:我们和清华大学交叉信息研究院的张景昭老师开展的一个合作,用我们的系统探索一些有意思的数学问题。
人人都能做研究,这会在什么时间点实现?
陈勇超:和Vibe Coding一样,Coding能力经历了一系列变化:从给高级码农用,到给初级码农、普通人用,再到现在几乎不需要人,AI自己就是一位高级码农。
AI自动做科研现在所处的阶段是,能帮助非AI专业的本科生发AI领域的A会论文,让本科生达到博士生的科研能力,也能在数学物理等领域发现一些人类觉得比较有价值的研究,但是想要AI实现那种创新性重大突破还有不少距离。
RSI在未来的发展有哪些节点?
陈勇超:首先,让AI接管那些纯粹在电脑里就能完成的研究,之后,不断扩大AI能覆盖的范围:一边延伸到更困难的计算任务;另一边,延伸到需要在真实实验室里动手做的实验,比如生物实验、材料实验。
总而言之,在广度上,它要成为各领域的专家;在深度上,它可以去攻克那些人类花很多年都做不出来的难题,比如数学领域,突然发现一个百年都未能证出的定理。
RSI的Timing,已经到来
你本科在中科大,主修理论与应用力学,博士又去哈佛、MIT,做各种各样的方向,最终为什么要回到AI这个领域了?
陈勇超:这是一段漫长的探索。我小时候的梦想是做基础科学、当科学家。从本科大二就开始进实验室做基础科学的研究,一直到博士的博一,我转了很多方向,比如力学、金属材料、核聚变,还有AI for Science。我给自己定了个规矩:每个方向都要做出比较好的一作的论文,再换其他的方向。本科时期的论文和研究成果,已经足够博士毕业。大二的研究课题,我以共同一作发了Nature Communications。
在大四的时候,在MIT暑研的导师特别看好AI for Science方向,我就去做了,那个时候大模型还没有出来。当时我发现做AI for Science最大的问题是数据,只有好数据能训出好模型,而且当时模型的泛化性特别差,任务或者场景稍微改动一些,它的能力就会变得非常差。
因为机缘巧合,我在哈佛的第一年开始做机器人的强化学习;之后就一直在做大模型相关的研究。当时并没有Recursive这个词,但我们已经经常运用自进化的思想做研究了,比如,让AI自己来优化自己的提示词、数据分布以及训练算法。
为什么说经过这么多转折,最后确定了RSI这个创业方向。
陈勇超:以前不做这个方向,是Timing没到。
我做Recursive Self-Improvement这个方向很早,2022、2023年的时候我的大部分研究就已经引入了RSI的很多理念,比如数据自进化、模型通过实验结果优化下一轮的实验参数、大模型自主训小模型等等,只是那个时候大家用的还不是RSI这个词。
真正让我发现它在产业界有很大价值,是我2025年在谷歌DeepMind做研究的时候,当时就在做Auto-research,我的Leader想让我优化整个Auto-research Pipeline。当时我对这个方向有顾虑,觉得那个时候模型还没那么强,做不出来人类觉得特别好的研究。
后来你看到了什么样的现象让你觉得模型能力已经非常强了?
陈勇超:今年2月,Claude Opus 4.6发布。我发现能够做出来一些人类觉得有价值的研究。
它的能力是一种若隐若现的朦胧感——它有很多能力让你觉得很惊艳,有很多能力让你觉得很不足。但正是那些惊艳能力,让我觉得这个方向很值得进一步做,而且是创业公司很好的机会。
当时我们发现,在独立完成从提出问题到得出结论的研究过程中,如果用一些开源Auto-research产品接入模型,表现都不理想。但给模型一个足够好的Harness,或者足够多的提示词,模型就能把很多任务完成得很好,甚至具备一些人类科学家的能力。
你是什么时候打算创业的?
陈勇超:两年多前。
为什么那个时候想创业?
陈勇超:有两个方面的原因,一方面是我慢慢发现AI的研究只能靠去大公司,或者自己创业,才有机会做出很有影响力的东西,另一方面是我遇到了很多也有创业想法的Researcher,时不时会一起碰撞对下一代大模型的观点,我当时的想法是,RSI是LLM和具身智能以后的第三波大机会,RSI需要训一个通用的跨领域模型,需要有很多模型训练的经验,以及跨领域的科研背景,这和我的个人经历是高度匹配的,果断决定All in创业。
DeepMind的offer,以及一些公司的联创邀请,你都拒绝了,做这些决定的时候内心有没有挣扎?
陈勇超:今年1月份,我挣扎了一个月。很多offer开的薪资很高,位置也很高,有些也挺诱人的。
很多人给我建议,在DeepMind待一两年再出来创业可能会更好。但你等不了,时代不可能等你,这和两年前不做大模型、一年前不做具身的情况是一样的,RSI现在就是最适合开疆拓土的时间点。
有哪些外界的声音,或者你自己个人的判断,认为自进化一定是第三波的机会?
陈勇超:只听外部声音是不准的,你需要自己去感受。二月的时候,我们搭了早期的自进化AI系统,搭上前沿模型,发现它已经能产生一些比较有实际生产力价值的成果了。
不仅如此,我们认为,仅通过Scaling Law是没办法让模型实现做创新性研究的能力,上一代模型和RSI的模型也完全不同,这是OpenAI和Anthropic难以垄断的方向。
为什么选择回国创业?
陈勇超:前期有很多人给我建议,提到过三个地方:中国、美国、新加坡。
从RSI创业角度来说,在哪个地方更重要、更有发展,我觉得是中国。