今天的具身模型,已经能够看懂环境、理解指令,并把看到的、听到的信息转化为机器人该怎么动的决策。但机器人最终还是要在物理世界里连续干活——从“眼睛看到”到“大脑决策”再到“手脚动起来”,整套流程都需要在极短的时间内完成闭环,这也是具身智能从 Demo 走向规模化应用,绕不开的核心关卡。
而当一个在云端运行良好的具身模型,放到机器人本体上,首先要面对的问题往往不是“模型够不够聪明”,而是推理系统本身:
- 模型部署到机器人上,能不能开机秒加载?
- 机器人本体的算力资源有限,能不能榨干端侧每一分算力?
- 每一次推理的延迟,能不能低到不拖后腿的程度?
- 开发环境里跑得好好的模型,到了机器人本体上,能不能稳定不翻车?
对于云端的聊天机器人而言,几百毫秒的延迟或许只是体验上的细微差异;但对于需要持续感知、连续决策和实时控制的机器人而言,几百毫秒带来的可能是动作迟滞、轨迹不连贯,甚至多次任务的失败。
而当机器人走向规模化落地,还会叠加另一笔更加现实的“经济账”:算力成本、功耗,以及有限硬件资源的利用率。
因此,具身智能规模化落地需要的,并不是简单地把云端推理框架“搬”到机器人本体,而是一套真正面向端侧场景设计的推理系统:在有限的算力、功耗和成本约束下,兼顾小 Batch、低延迟与持续实时交互,并充分挖掘硬件的性能上限。
今天,无问芯穹联合清华大学、上海交通大学,正式开源具身智能端侧推理引擎——APXInf,超前卡位具身智能从模型能力走向规模化落地的核心环节。APXInf 支持 RTX 4090、Jetson Orin、Jetson Thor 等主流计算平台,覆盖从模型开发、效果验证到机器人本体部署的完整链路。它关注的不只是让具身模型在真实机器人上能够“跑起来”,更希望可以在有限资源下“跑得够快、够稳,也足够容易接入拓展和持续迭代”。
目前,APXInf 已实现:
- PI 0.5 FP8在Jetson Thor上实现端到端推理延迟从 278ms 降低至 26 ms 以内
- 在 FP8下达到 38.46Hz 推理频率,完全满足机器人多场景下实时控制对推理频率和响应延迟的要求。
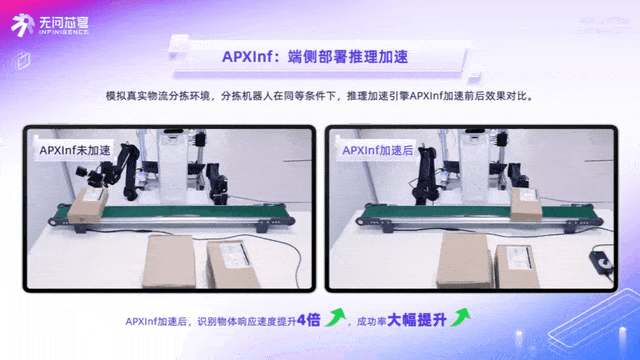
通过针对机器人端侧场景的系统性推理优化,APXInf 希望能够进一步缩短具身智能从 POC 走向规模化落地的那“最后一公里”。
开源地址:
- GitHub:https://github.com/RLinf/APXinf-robo
- Quick Start:https://github.com/RLinf/APXinf-robo#quick-start
01 让具身模型在机器人本体上跑得更快、更稳、更敏捷
当下具身智能的规模化落地,实际上同时面临两类需求:
一端,是机器人本体对推理系统提出的严苛要求:极致性能、低延迟、低功耗与高稳定性;
另一端,是开发者越来越强烈的工程诉求:模型能够快速接入、能力能够敏捷验证、系统能够持续扩展。
但现实是,性能与工程效率往往很难同时兼顾。
现有的一些方案能够跑得快,却需要大量复杂的底层适配与工程集成;有的方案运行稳定,却难以满足机器人实时控制所需要的低延迟;还有一些方案虽然接口简单,但面对不同模型、不同硬件和不断变化的 VLA 架构时,扩展成本依然很高。
APXInf 则罕见地同时兼顾了性能与工程效率,让具身模型在机器人本体跑得“更快、更稳、更敏捷”。
1. 更“快”:端到端优化推理性能SOTA,让实时控制成为可能
APXInf 的“快”,并不是单纯追求某一个模型算子的峰值性能,而是围绕机器人真实执行链路进行端到端优化。通过Pipeline、Graph、Kernel及量化等多层优化,降低具身模型端到端推理延迟。同时通过冗余特性的系统设计,为模型进行定制化的运行时,在更加轻量化的同时实现极致的性能挖掘,搭配上 Agent4Kernel 技术进行极限优化的融合算子,实现性能SOTA:
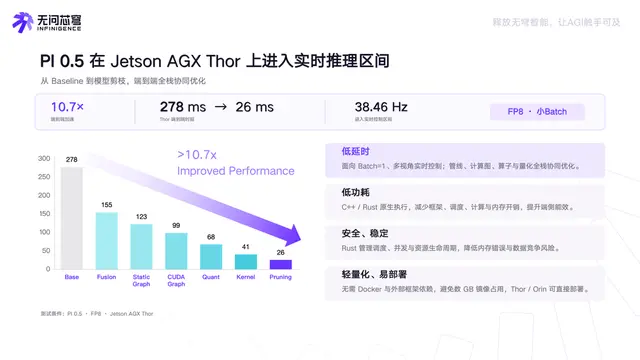
在 Thor 上,APXInf 将 PI 0.5 FP8 的端到端推理延迟从 278ms 降至 26 ms 以内,频率可达 38.46 Hz,为机器人实时感知与控制提供更充足的响应空间。
10.7 倍的推理延迟下降,对机器人而言,意味着更快的“感知-决策-动作”闭环,也意味着具身模型有机会在真实机器人上进入更加实时的工作状态。
2. 更“稳”:可靠原生框架,面向长期持续稳定运行
机器人端侧推理并不是“一次跑通”就结束了。它面对的是长时间运行、连续感知与控制、有限计算资源,以及感知、推理、控制等多个模块同时运行的复杂环境。对于机器人而言,真正难以接受的并不是偶尔“慢一点”,而是在持续运行过程中出现抖动、异常、中断,甚至因为内存、并发或资源管理问题导致整个系统失稳。
因此,APXInf 的“稳”,强调的是真实部署环境中的可预测性和持续运行能力。
创新架构:使用 Rust 系统语言构建的极简运行时 + Python 易用接口
- 利用冗余特性设计,打造极简化运行时,降低运行开销的同时做到可核查、可验证
- 利用 Rust 语言提供的内存安全特性,进一步提升引擎稳定性、降低易错面,从源头规避内存风险
- 通过 Python 接口封装,保留开发者熟悉的调用方式,兼顾底层硬核与上层易用。
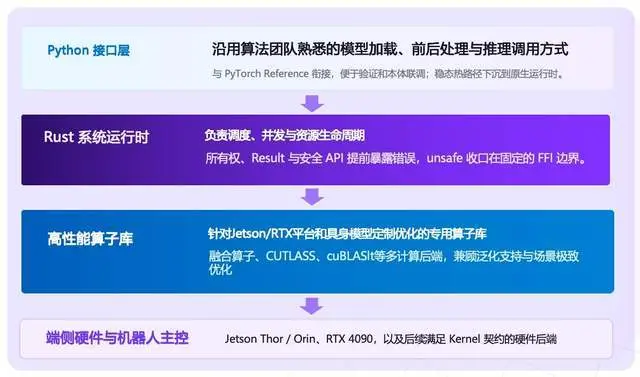
这也是 APXInf 面向真实机器人部署所做的架构选择:既追求端侧性能,也关注系统长期运行的稳定性,同时尽可能降低开发者的使用门槛。
3. 更“敏捷”:降低接入与优化成本,面向 Agentic Native 演进的推理系统新范式
如果说前面的努力解决了“跑得够不够快”和“能不能长期稳定地跑”这两道题,那么 APXInf 进一步关注的问题是:面对日益丰富的具身模型和越来越复杂的具身系统,模型究竟应该如何更快、更敏捷地接入,并持续迭代优化?
传统的推理引擎多使用编译技术或降低开发难度来解决新模型接入的问题,但往往很难兼顾极致的性能和模型接入效率。如今,大模型能力日新月异,我们得以在保持对模型极致优化的同时,利用 Agentic Engineering 快速实现新模型的适配与接入——这一能力不仅可以加速我们自身的研发迭代,还会开放给 APXInf 的开发者,让用户自研模型的接入与优化变得简单和敏捷。
为此,APXInf 从设计之初就以适配 Agentic Engineering 研发流程为出发点,重新思考推理引擎的系统设计,通过冗余特性、功能隔离、工具箱模型等方法,显著提升 APXInf 与 Agentic Engineering 的适配度,降低研发门槛,使得 Token 可以更便利高效地转化为生产力。
APXInf 也将面向 Agentic Native 持续探索和迭代。我们希望 APXInf 带来的并不只是降低某一个模型的部署门槛,而是去探索一种全新的面向 Agentic Engineering 时代的推理系统构建范式:让推理引擎不再只是一个被动执行模型的 Runtime,而是连接模型、硬件、机器人与开发者,推动 Agentic Infra 持续演进。
02 开源清单
APXInf 本次首发支持两款具身模型: PI 0.5、WALL-OSS 。
硬件支持 Jetson Orin、Jetson Thor 及 RTX 4090,并提供统一的模型接入方式。
Roadmap
- 支持更多的模型,VLA、VLM、世界模型等(已在适配中模型:Qwen、Groot)
- 持续优化重点开源模型,扩充SOTA模型列表
- 极致的 nvfp4 性能优化
- 持续拓展国产化生态支持,支持国产芯片算力后端,支持国产机器人操作系统
- 适配AMD等行业主流芯片
03 RLinf × APXInf:一条工程链路上的前后端
对于具身智能而言,模型训练与本体推理从来不是彼此割裂的两个环节,而是同一条工程链路上的前后端。
2025 年 9 月,无问芯穹联合清华大学等团队开源了全球首个面向具身智能的大规模强化学习训练开源框架,专为通过强化学习对具身大模型进行后训练而设计。
当训练完成的具身模型真正进入机器人本体并开启规模化应用后,下一步需要解决的,正是端侧推理与部署:在有限算力和功耗约束下,以小Batch的工作负载实现更低延迟、更高吞吐和更稳定的实时运行。
APXInf 衔接的正是这一环。
它将 RLinf 的能力从模型训练与评测进一步延伸至机器人端侧推理与部署。此次开源,APXInf 也将作为 RLinf 开源生态中的端侧推理项目首发,让开发者能够沿着同一套具身智能技术生态,完成从模型训练、效果验证,到本体部署与真实机器人运行的完整流程。
从训练,到推理;从云端,到本体;从“模型会做什么”,到“机器人真正做出来”——APXInf 正在补上具身智能规模化落地的关键一环。
04 开源招募
APXInf第一版只是一个起点。
无问芯穹希望的,是与具身模型开发者、机器人团队和端侧系统开发者一起,把模型接入、运行优化和本体部署沉淀为更加标准、可复用,也更适合代码 Agent 参与的开发流程。
如果你:
- 正在尝试把 π0.5 等具身模型部署到机器人本体;
- 正在基于 RTX 4090、Jetson Thor或Orin等硬件进行项目开发;
- 正在为新的具身模型寻找端侧推理引擎;
- 希望参与具身模型接入Skill和Agentic部署流程的建设;
欢迎体验 APXInf、提交 Issue 或贡献 PR。
- GitHub:https://github.com/RLinf/APXinf-robo
- Quick Start:https://github.com/RLinf/APXinf-robo#quick-start
本文由无问芯穹提供,量子位获授权转载,观点归原作者所有。