堆了三年数据,具身智能终于开始关注“身体”。
作者|刘杨楠
编辑|栗子
近两年,具身智能的技术叙事大多和数据有关。各路从业者试图用各种方式获取机器人运动和物理操作的轨迹数据,以此作为抵达通用机器人这一终极愿景的催化剂。
但近期召开的ECCV 2026上,一篇题为《Gripper-aware Vision Language Action Models》(下文简称: GVLA)的论文提供了一个新思路。
现有VLA模型普遍默认“夹爪不变”,训练数据也大多由平行两指夹爪采集,而这篇论文把末端执行器的形态差异引入模型训练。
实验结果显示,引入这一条件后,模型在仿真任务上的成功率、跨夹爪的适配效率都明显提升。这意味着,在扩大数据规模之外,VLA的能力提升还可能来自数据维度的丰富。
这项研究由利物浦大学计算机科学助理教授黄保茹主导。黄保茹曾在帝国理工学院从事机器人研究并完成硕士和博士学位,2023年以来围绕语言驱动的抓取与操作连续发表多篇论文,与Physical Intelligence(PI)联合创始人Quan Vuong(π0 系列机器人基础模型的核心作者之一)两次联合发表论文,并均被ECCV收录。
PI是当下全球具身智能领域的领先团队之一,能与其研究者两度在ECCV这样的顶会上联合发表论文的团队,无论在国内还是国际都不多见。而这两次合作,黄保茹团队都是主导方。
1.照亮具身数据的“盲区”

GVLA论文从一个常见的生活场景出发——假设桌面上放着一个薄而扁平的盒子,如果机器人末端装的是吸盘夹爪,它可以从正上方靠近,直接把盒子吸走;若换成平行两指夹爪,链路就复杂了。由于盒子太薄,垂直下爪没有可夹持的立面,机器人需要先把盒子推到桌沿、让它探出桌面一部分,再从侧面夹起。
“推到桌沿”这个动作不出现在任何一句任务指令里,它由两指夹爪的形态决定。GVLA论文由此总结道:“(机器人)达成同一个任务目标,并不意味着共享同一套操作策略。”
这个观察对应着当前具身数据建设中的一个结构性问题。
过去两年,行业主线是扩大数据规模。以机器人操作轨迹数据量来看,RT-1达13万条,Open X-Embodiment达百万级,GraspVLA更是达到十亿级。
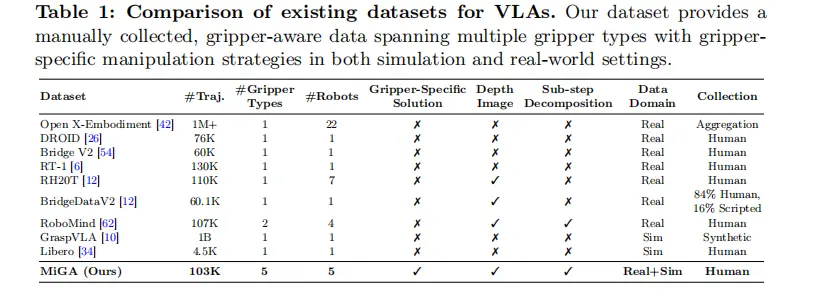
但GVLA论文的数据集对比表显示,这些数据集几乎全部基于平行两指夹爪采集,是否包含夹爪特定策略一栏均为空白。即便是覆盖7种机器人本体的RH20T,末端执行器也只有一种。
可见,机器人平台数量、末端执行器形态以及同一任务目标下的策略多样性,是三个相互独立的维度。数据总量的增长只覆盖了更多任务和场景,没有覆盖执行器。
需要说明的是,夹爪在此前的研究中并非完全没有被表示过。目前已有若干团队意识到,不同的末端执行器需要不同的表示方式——一类方法基于运动学拓扑做图编码,一类基于物体点云与夹爪的距离场做几何编码,还有研究在共享的本征抓取空间(eigengrasp space)与潜在动作对齐来做跨夹爪迁移。
但这些工作都聚焦相似夹爪之间的抓取位姿迁移。位姿迁移只处理执行器最终抓在哪个点,而真实操作从规划、接近、接触到执行是完整的动作序列。
因此,更换执行器后,机器人不能只调整抓取落点,整条轨迹的规划都会随执行器形态改变。例如同样是拿起一个薄而扁平的盒子,平行两指夹爪往往需要先把物体推到桌沿、再从侧面夹取;而吸盘夹爪则可直接自上而下吸附。
然而,目前的夹爪表示方式没有学习夹爪特征(夹爪tokenization),忽略了夹爪形态引起的操作策略差异。
GVLA论文在相同的π0模型上检验了三种现有的夹爪编码方式:MLP编码和VQ-VAE编码给出的表征相似度与夹爪形态没有对应关系,语言提示则让不同夹爪的表征几乎重合。三种方式都无法让模型从表征中区分夹爪类型。
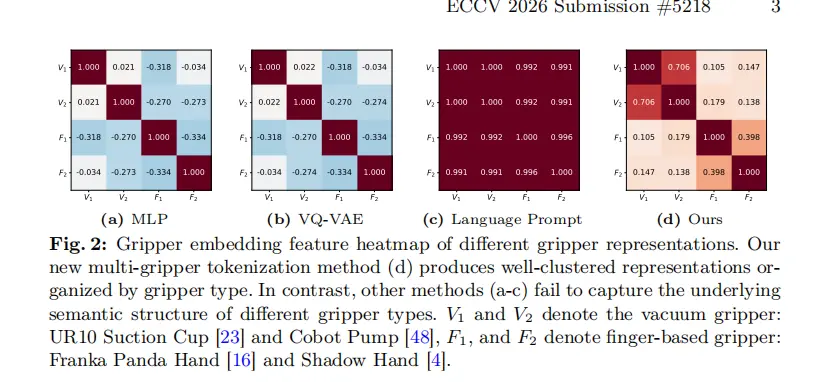
换言之,VLA的训练过程中,现有关于夹爪的表示不能构成有效的输入。这便导致今天的VLA模型普遍无法学习目标相同、执行器不同的情况下,操作策略应如何调整。
与此同时,产业端的执行器类型正在加速多样化。吸盘已广泛用于物流分拣,三指夹爪、软体夹爪和五指灵巧手正在进入装配产线。模型的训练前提与真实世界的硬件构成正在脱节。
GVLA 论文要补的正是这一环。
2.拆解GVLA的两项成果

GVLA论文通过两项核心工作填补了执行器信息的缺口——多夹爪数据集MiGA以及夹爪感知的模型框架GVLA。
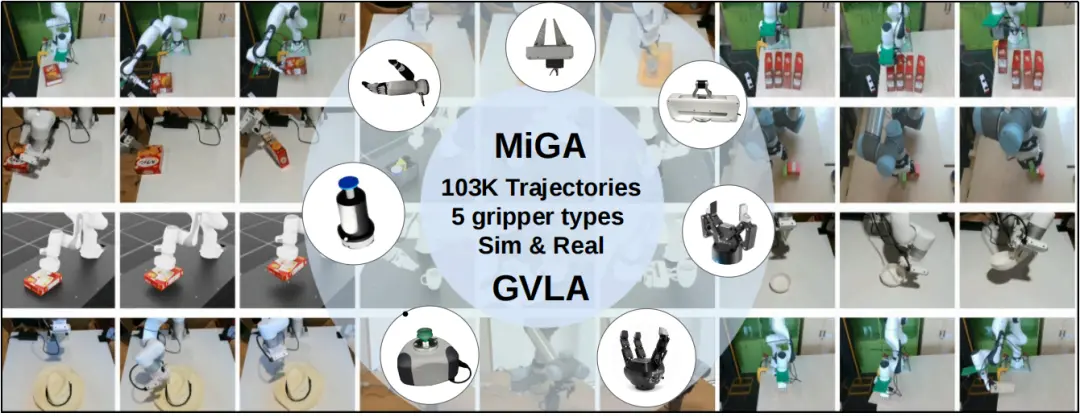
MiGA包含103000条演示、36项任务、5类夹爪、5个机器人平台,真实环境与仿真环境并行采集。
5类夹爪覆盖当前产业界的主流形态——平行两指(Franka Panda、Robotiq 2F-85)实现两指形封闭(form-closure);三指(Robotiq 3-Finger)提供多点接触;黄保茹团队自研的软体两指提供柔顺自适应;吸盘夹爪(Cobot Pump、UR10 Suction Cup)依靠吸附抓取;五指灵巧手(Inspire Hand)提供高自由度的多点接触操作。
这些夹爪的差异不只在于几何形状,还在接触力学、力传递和可控自由度上。因此,同一个操作任务在不同夹爪下需要截然不同的策略,包括接近方向、接触区域选择、预抓取构型的变化。借助多种夹爪类型,MiGA不仅能学习轨迹策略,还能学习不同夹爪与抓取策略之间的结构化关系。
5个机器人平台则涵盖仿真与真实两类场景。仿真侧基于NVIDIA Isaac Lab搭建,真实侧使用xArm7、Franka Panda和UR5三台机械臂,均配备腕部与第三视角的多视角RGB-D相机,让数据集能够记录全场景视角数据,和末端执行器视角形成互补。
在任务设计逻辑上,每项任务至少由3类夹爪分别采集,共形成132组“夹爪—策略”组合,每组附带自然语言描述。
36项任务按场景分为四类,分别放大执行器差异的不同侧面:
对于单件抓取任务,团队通过变化物体的几何形状、材质与位姿来扩大任务多样性,以此检验接触可行性如何随夹爪形态改变——平整表面更适合吸附抓取,不规则形状则更依赖多点接触或柔顺包络;堆叠场景引入遮挡与碰撞约束,要求针对不同夹爪做预抓取规划;受限空间场景放大夹爪尺寸、可达性与对准精度之间的矛盾;语义场景要求结合物体功能与任务语境,例如端起盛水的杯子时,接触位置需要避开液面一侧。
论文用两个案例直观体现了MiGA的差异点。
一个例子是从堆叠的盒子中取物:平行夹爪会先把目标盒子推出堆叠、再从上方夹取,吸盘直接从顶部吸附,接近方向、接触位置、预抓取构型均随夹爪改变。
另一个例子是取放一个盛有物品的盘子。执行器需同时满足接触位置与端起后的平衡。例如,灵巧手能够通过调整手指的包裹方式稳定重心,吸盘则需在盘面中心附近寻找吸附点。
这组案例共同指向一个结论:MiGA数据集不只是笼统搜集末端执行器的操作轨迹,而是能够真正沉淀出不同执行器针对同一任务目标给出的不同解法——这正是MiGA最核心的信息增量。
在成功演示之外,MiGA还保留了子步骤分解、夹爪策略标注,以及约5%的失败示例,包括抓取不准、物体掉落和碰撞。成功样本提供如何完成的监督,失败样本标记本体局限与模型的能力边界。
不过,要想充分释放这套数据集的价值,还需要一个新的模型架构,即夹爪感知的模型框架GVLA——一个旨在把夹爪信息纳入现有VLA模型的框架。
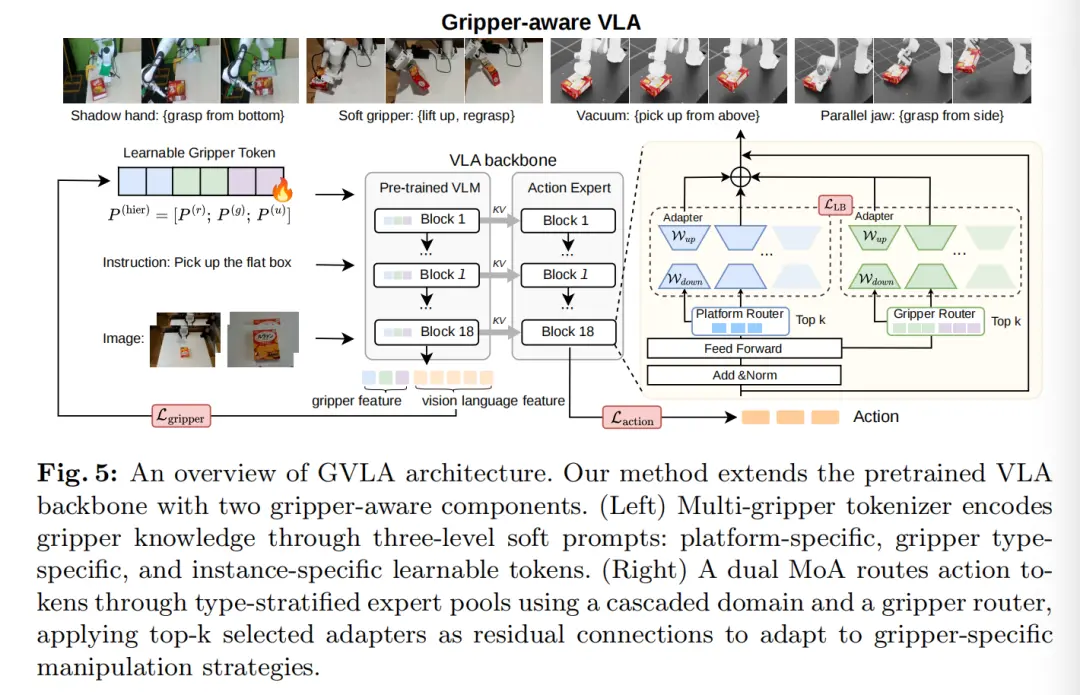
实现这一目标依赖两个组件。
第一个组件是多夹爪表征(multi-gripper tokenizer)。
针对前文所述现有编码方式无法区分夹爪类型的问题,GVLA不使用固定文本提示或 MLP这类通用编码器,而是采用软提示(soft prompt)。
软提示把执行器信息表示为一组可学习的向量。这组向量在训练开始前没有预设含义,其内容完全由训练过程决定。模型每完成一次任务,动作预测与真实演示之间的误差都会反向传播,连同当前的夹爪类型,逐步把这组向量调整成更有利于完成任务的形态。换言之,模型不会被告知吸盘需要什么样的操作策略,它能在执行任务的过程中,自己学会吸盘夹爪到底需要什么样的操作策略。
多夹爪表征通过三级软提示编码夹爪信息:
-
平台token捕获不同机器人平台特有的运动学结构与配置;
-
夹爪类型token编码同类夹爪共有的、由夹爪作用机制决定的操作先验;
-
实例级token则对每只夹爪独有的细粒度特征进行建模。
分级的意义在于分离不同夹爪的共性与个性。例如,同属吸盘的两只夹爪可以复用吸附式操作的共性能力,但每只夹爪的个体差异仍需单独保留。当模型遇到一只训练中从未见过的新夹爪时,至少能继承其所属类型的操作先验,很大程度上提升模型训练过程中的数据效率。
论文的表征可视化实验验证了软提示的有效性。实验结果显示,同一类夹爪在表示空间中聚拢,不同类夹爪彼此分离。这意味着模型内部的表征与执行器的真实分类体系建立了对应关系——执行器信息第一次以结构化的形式进入 VLA 的表征空间,从一段模型无法利用的附加说明,变成了可以直接参与推理的输入条件。
第二个组件是双重MoA(dual Mixture-of-Adapters)。多夹爪表征作用于模型的输入端,但输出端还需单独的机制来保证操作策略的有效性。
VLA模型内部负责把视觉与语言信息转化为动作序列的部分称为动作模块(action expert),由多层网络堆叠而成。黄保茹团队通过逐层探针(layer-wise probing)的结果显示:前部各层的表征几乎不随夹爪类型分化,差异集中在最后一层。
这说明网络前部处理的是与执行器无关的通用视觉-语言理解,执行器差异只在临近动作输出时才需要介入。GVLA据此把两组专家适配器安置在动作模块的最后一层——既不干扰主干网络已学到的通用能力,又能直接调制最终的动作生成。
总体上看,多夹爪表征回答“模型接收到的身体信息是什么”,位于输入端,决定模型输入的质量;双重MoA则回答“这些执行器信息在何处、如何改变动作输出”,决定模型生成的操作策略充分适配对应的夹爪类型。
这套数据与模型的组合已经在仿真场景和真机场景上分别接受了检验。
仿真环境中,基于π0.5的GVLA在四类任务上平均成功率66.00%,较π0.5基线的58.38% 提高7.62个百分点。
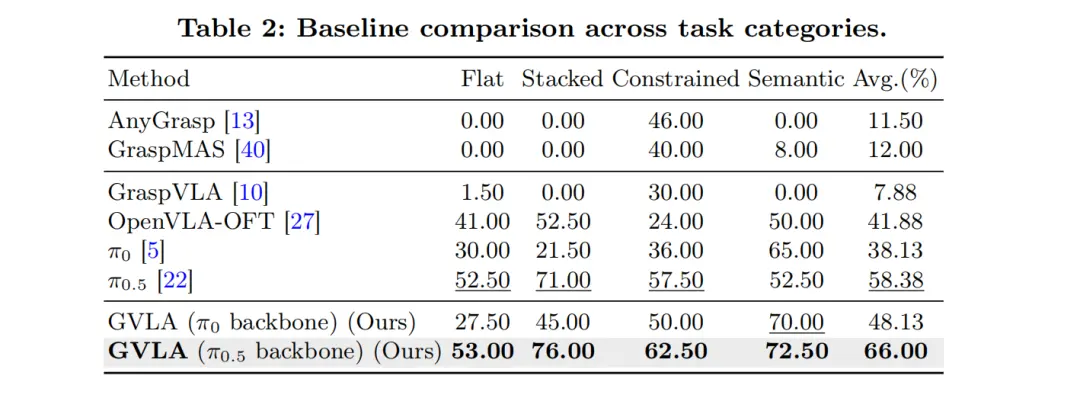
更值得注意的是对照组的数据。用十亿级合成数据训练的GraspVLA,平均成功率为7.88%。这个对比说明单纯扩大数据规模确实无法弥补执行器维度信息的缺失。
除了验证成功率的数据,论文还检验了模型是否真正学会了让操作策略随夹爪类型变化而变化。具体方法是保持视觉输入与语言指令不变,仅改变输入的夹爪形态,测量模型预测动作的变化幅度。结果显示,GVLA的行为分化程度明显高于基线,说明将执行器信息引入模型训练过程确实能让模型生成更精准的操作策略,提升训练效率。
真实机器人方面,研究团队使用UR5机械臂与Robotiq 2F-85夹爪进行验证:仅以10条演示、20000步微调即可完成少样本适配;整体成功率较基线有所改善,个别任务与基线持平。
零样本的跨物体泛化,以及新任务、新夹爪的少样本适配,分别在各自的实验设置下得到验证。
从结果看,GVLA 对执行器问题的处理相当完整——数据、表征、动作生成、实验验证,每一环都有相应改进,并取得明显成效。但这种完整性引出一个问题:执行器盲区长期存在,数据规模更大的玩家不在少数,为什么是由这支团队先把它做成系统性的工作?答案要从黄保茹过去三年的研究经历中寻找。
3.黄保茹的“执念”

GVLA对执行器问题的深刻认知并非“拍脑袋”的灵光一现,本质是黄保茹及其团队过去三年研究成果的自然延伸。
此后,黄保茹参与的系列研究沿着同一主线展开——让机器人把自然语言指令转化为可执行的物理操作。这条主线可以拆成四个环节:
第一个环节是语言理解,让机器人听懂指令。
2023年发表的论文《Language-driven Scene Synthesis using Multi-conditional Diffusion Model》被NeurIPS接收,其成果为一系列语言驱动机器人抓取的研究埋下伏笔。
这篇论文提出了“引导点”(guiding points)方法:给定文本指令、人体动作与已有物体位置,多条件扩散模型据此生成新物体的三维形状与摆放位置。由于条件的作用被显式编码在引导点中,每种条件对生成结果的影响都可以单独衡量。文本指令一变,引导点随之改变,生成结果跟着改变,物体替换、位置移动、形状修改等场景编辑由此成为可能。
这项工作更长远的价值在于,证明了文本这类抽象条件可以与人体动作、物体位置等几何条件一样,作为显式约束进入扩散生成过程。同时,论文结尾也指出,该机制可以迁移至语言驱动的抓取任务上。
2023年公开的 Grasp-Anything(ICRA 2024)瞄准抓取数据的多样性瓶颈——真实采集成本高,既有数据集覆盖的物体种类有限,直接制约了模型的泛化。这项工作借助基础模型得到百万级带文本描述的抓取数据,覆盖超过300万种物体,是全球最早开源的、基于语言实现复杂抓取的方向之一。
Language-driven Grasp Detection(CVPR 2024)进一步将“抓哪个物体、抓什么部位”的语言意图输入扩散模型,生成抓取姿态。语言从单纯的数据标注,变成了生成抓取姿态的约束条件。
第二个环节是让模型理解物体功能和三维姿态。机器人不仅要听懂抓什么物体,还要听懂具体抓哪里、用什么姿态抓取。例如,同一个杯子,拿起来和倒水对应不同的功能区域和接触姿态——前者抓杯身,后者需要握住杯把并预留倾倒空间。
Language-Conditioned Affordance-Pose Detection in 3D Point Clouds(ICRA 2024)则在三维点云中检测物体上和具体操作策略对应的功能区域,且不局限于预设的功能标签,任意开放词汇的操作描述都可以驱动语言引导的扩散模型生成对应的六自由度交互姿态。操作意图由此被落实为末端执行器在空间中的具体姿势。
2024年被ECCV接收的《Language-Driven 6-DoF Grasp Detection Using Negative Prompt Guidance》则把语言驱动的抓取检测扩展到三维点云中的六自由度抓取。团队构建了Grasp-Anything-6D数据集,并提出一种“负向提示引导”(negative prompt guidance)的扩散模型——语言指令不只把夹爪引向目标物体,同时还能让夹爪主动避开不想要的物体。
这篇论文的联合作者中,出现了Physical Intelligence联合创始人 Quan Vuong 的名字,这是黄保茹团队与PI长期合作以来,首个公开发布的成果。
第三个环节是动作过程的表征。抓取不是瞬时动作,模型还需要理解操作过程中物体状态的实时变化。
Robotic-CLIP(ICRA 2025)将 CLIP 从静态图文理解扩展到动作数据,团队采集并标注约31万段动作视频、近740万帧画面,通过对比学习建立视频变化过程与语言描述之间的对应关系。
然而,这项成果有着清晰的能力边界。因为模型理解动作过程与输出操作策略是两件事,动作过程表征本身无法评价对应操作的成败、更无法更新策略。
由此,黄保茹开始带领团队尝试利用反馈调整推理。
GraspMAS(IROS 2025)用三个智能体协作完成语言驱动的抓取检测,包括Planner拆解任务、制定策略;Coder生成并执行检测代码;Observer评估中间结果并反馈修正意见,循环迭代直至给出答案。这套系统旨在让末端执行器能够利用反馈学会操作策略的生成逻辑。
黄保茹用三年时间将“语言驱动物理操作”的相关研究层层深入,但GraspMAS在薄平面和堆叠两类任务上的成功率为零——它清楚地表明,强大的语言识别与推理能力,依然无法替代不同本体形态下的操作策略学习。
面对一只无法直接夹取薄盒子的两指夹爪,再准确的语言理解也推导不出先“推到桌沿”这个动作。它来自执行器形态与物体几何之间的物理关系,只能通过对执行器形态的建模获得。
因此,想要机器人做出精确的灵巧操作,最后一环需要执行器层面的具身态数据与模型来补齐,这便是GVLA这篇论文的来由与核心价值所在。
值得注意的是,GVLA已经是黄保茹团队与PI团队又一次合作里程碑。可见,“执行器差异如何影响操作策略”这个题目是从黄保茹过去三年的研究主线内部生长出来的。
4.具身智能的下一座高峰

结合具身智能行业的发展现状来看,GVLA极有可能撬动一种全新的范式。这个范式变化关系到具身产业链的每一个参与方。
其影响首先落在数据层。
GVLA的对照实验表明,具身数据的重心,正在从单纯的规模较量转向数据结构的较量。除了轨迹数量,数据集的评价维度至少还要追问三个问题:数据集是否记录了同一目标在不同执行器下的不同解法;是否保留了失败样本;是否将执行器的具身态数据作为核心输入引入模型训练流程?
第二层影响关乎数据效率。当模型对执行器形态建模,更换夹爪的适配成本从重新大规模采集,下降为10条演示、20000步微调的少样本过程。
由此推导,在训练模型时引入执行器信息,可以构成全新的scaling路径。模型能力的增长,除了依赖数据量的堆积,还可以来自数据维度的扩展。同样十万条数据,覆盖五种执行器与只覆盖一种,前者能够提取的有效信息更多。
第三层影响,便是GVLA的模型架构设计能够大幅提升具身模型的跨本体泛化能力。
目前,末端执行器越发多样化,而模型厂商与本体厂商之间此前缺少协同。本体厂商设计的夹爪,模型无法直接利用;模型的训练策略,又和训练时使用的执行器深度绑定。
而GVLA的三级表征(平台、类型、实例)提供了一种衔接思路:硬件规格以结构化的方式引入模型训练过程,执行器差异甚至成为训练过程的核心变量,而非核心瓶颈。这在很大程度上提高了具身模型的跨本体泛化能力,真正加速行业探索通用机器人这一终极愿景。
不过,GVLA 将夹爪差异纳入模型的尝试,也把一个更深层的问题推到行业面前:当机器人开始拥有不同的“身体”,它该如何从经验中持续地自我改进?
自我进化是当前 AI 研究的热门方向,机器人领域也不例外。真正的难题在于,机器人不仅要完成任务,还要能分辨失败来自哪里、把经验留下来,并在下一次任务中完成自我迭代。
GVLA把执行器条件带入模型之后,这个难题变得更具体,因为执行器差异正是失败归因中最容易被混淆的变量。一次抓取失败,可能来自感知、来自策略,也可能来自末端执行器的物理限制。
那么,机器人的经验到底以什么形式保留?模型如何区分感知、策略、接触与硬件限制导致的失败?执行器形态变化之后,哪些经验仍可复用?
这些追问,与近年来业内讨论的“递归自我进化”(Recursive Self-Improvement,RSI)指向同一个内核,都需要让机器人能够学会如何对失败归因、沉淀成功经验,并在后续任务中复用这些经验。黄保茹也十分认同RSI的核心思想。在GVLA之后,她也将带领团队围绕失败归因、经验保留与跨执行器复用等问题继续深入研究,继续攀登下一座高峰。
回看黄保茹团队过去三年的研究历程,其主线从语言理解推进到对执行器建模,已经完整走过了一条从语言到身体的技术迭代路线,在每个环节都留下了经过顶会检验的工作成果,又用实验准确明确每条路线的边界,并在下一份成果中完成又一次自我迭代。
与PI的持续合作,也让这条研究脉络始终与全球最前沿的模型进展保持对话。数据集、模型框架、真实机器人验证,再加上对问题边界的清醒认知,这几项能力同时出现在一个团队身上,构成了GVLA这项成果真正的稀缺性所在。
因此,MiGA数据集和GVLA模型架构虽然不是终点,但这套系统对于执行器具身态数据的突破性认知和应用,也为接下来整个行业抵达通用机器人的终极愿景提供了一块必不可少的关键一环。
(封面图来源:AI生成,文中图片来源:论文《Gripper-aware Vision Language Action Models》)
END.