总结了一些平时常用的数据处理命令
生信入门 linux实用基础1 2 3
生信入门 R实用基础1 2
运算符
- 算术运算符
加法(+) 减法(-) 乘法(*) 除法(/)
求余(%%) 求指数幂(^) 求模数(%/%) - 关系运算符 :返回逻辑值
大于(>) 小于(<) 等于(==)
小于或等于(<=) 大于或等于(>=) 不等于(!=) - 逻辑运算符
逻辑与(&) 逻辑或(|) 逻辑非(!)
逻辑运算符&&和||仅考虑向量的第一个元素,并给出单个元素的向量作为输出 - 赋值运算符
<−,<<− 和 = 叫作左分配符,-> 和 ->> 叫作右分配符 - 其他运算符
冒号运算符(:) ——为向量创建一系列数字 ;
成员运算符(%in%) ——用于识别元素是否属于向量;
转置相乘(%*%) ——用于将矩阵与其转置相乘
变量类型与数据结构
-
变量的类型判断及转换
is.*() 与 as.*() : 如 is.list() as.list() -
查看数据结构
str() -
查看变量类型
class() mode() typeof()
class:是一种抽象类型,或者理解为一种数据结构,
mode:表示对象在内存中的存储类型,numeric(Integer/double), complex, character和logical
当x是数据框的时候,class返回dataframe,mode返回list -
如果是list取元素要用双括号[[ ]]来取,不然[ ]只能取到子list
数据创建、字符连接
seq(1,10,by=2) #13579 rep(2:5,times=2) #23452345,对整体重复 rep(2:5,rep(2,4)) 或 rep(2:5,c(4,4,4,4)) #22334455, 每个数都重复2遍 append(x, 0:1, after = 3) #追加, 在x的第3个元素后添加0,1 sample(1:100,10) #从1-100中随机取10个数,常用于从样本中随机取样 rnorm(5,mean = 2) #平均数为2,服从正态分布的5个数 runif(5,min=10,max=100) 或 runif(5,10,100) #10到100的5个随机数 (默认范围是0-1) set.seed() #设定随机数种子,使得结果可复现,常与runif共用 paste( 'a1', 1:20, sep='_' ) #粘贴创建a1_1~a1_20(若不指定sep则默认为sep=' ') paste0( ) 或 paste( , sep='' ) #无连接字符进行粘贴 搜索和替换
grep(pattern, x, value = FALSE, invert = FALSE) #搜索函数,返回pattern在 x中位置下标, grepl(pattern, x) #搜索函数,返回逻辑向量 which (is.na(x),arr.ind =T ) #会输出TURE的位置\下标, 该例为a中NA值的位置,arr.ind =T显示该值的行列名 match("hello",a) #等价于which(a=="hello",arr.ind = T) 搜索字符串在a中位置 colnames(b) %in% c("c2","c3") #返回逻辑向量 - 一次搜索选择多个字符,进行数据集条件选择
no <- colnames(b) %in% c("c2","c3") c <- b[,!no] - 根据特定条件选择、更改数据框内容
celltype <- data.frame(ClusterID=0:6, celltype=NA, stringsAsFactors = F) celltype[celltype$ClusterID %in% c(1,3,5), 'celltype'] <- "WT" - gsub()替换函数,其中pattern是要替换的字符,replacement是替换的字符,x是对应的string或string vector,ignore.case表示是否忽视大小写。
gsub(pattern,replacement,x,ignore.case=FALSE) 加载数据与添加数据集内容
with(x,{ }) #{ }内操作都可不用输入x$, 在{}内赋值用<<-代替<- attach(x) #添加数据框x到路径,之后可不用输入x$ detach(x) #移除数据框x within(x,{ }) #和with函数类似,但是可以更改数据框内容, #例如: a <- data.frame(c1=1:6, c2=7:12) a <- within(a,{ c6 <- NA ##注意要先创建新一列,赋值NA c6[c1<=3] <-"F" c6[c1>3] <-"M" }) - transform( ) 函数也可以按需创建新变量并保存在数据框 ,更方便
a <- data.frame(c1=1:6, c2=7:12) transform(a, c3=c1+c2, c4=1:6) 数据集的条件选择
- subset( )函数 :
subset(dataframe, choose_condition, choose_zone)
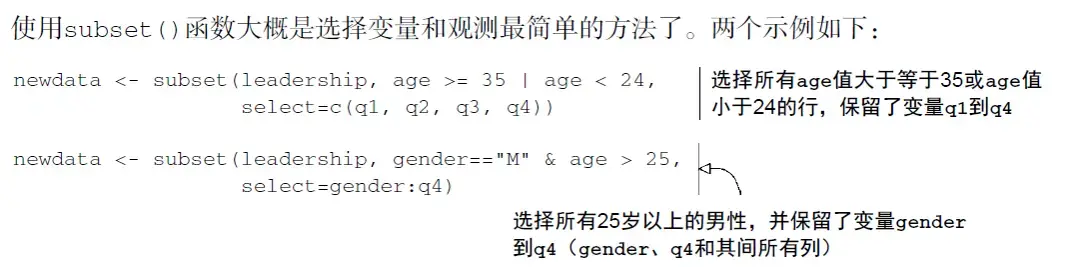
- 或者用以下笨方法:
attach(d) e <- d[SEX=="M" & c5>25, which(colnames(d)=="c3"):which(colnames(d)=="SEX")] detach(d) - select( )函数 按名称选取列
install.packages("dplyr") library(dplyr) select(x, c1, c2, c3) # 选取x中的c1到c3列 select(x, -(c1: c3)) # 选取x中的c1到c3之外的所有列 数据合并与比较
merge(x, y , by ="ID" ) # 根据ID列来合并数据框x与y rbind( ) #按照行合并、纵向追加 cbind( ) #按照列合并、 横向追加 intersect( ) #取交集 union( ) #并集 setdiff( ) #找不同 setequal( ) #判断相同 转置、排序
t() # 对行列进行转置互换 sort( ) #从小到大排序 , 设置 decreasing = T则从大到小排序 order( ) # 返回向量从小到大排序的位置下标,decreasing = T则从大到小降序排序(或者变量前加-), reorder(v1,v2) #根据v2的值对v1进行排序 字符串提取、大小写转化
substr("HELLOW",1,3) #从字符串“HELLOW”中提取1-3位 substring("HELLOW",1) #从字符串“HELLOW”中提取1到最后一位 strsplit("a.b.c", "[.]") #从字符串"a.b.c"中以“.”为分割提取字符,结果为"a" "b" "c" toupper(a) #字符串变大写 tolower(a) #字符串变小写 数理统计常用函数
- 统计
table() #分类统计每个因子的counts数 summary() # 统计概要,给出每列中位数、均值、大小值等 length( ) #显示对象中元素或成分的数量 nchar( ) #统计字符串长度 - 各类运算
na.omit() #去除NA值,若为数据框等会直接删除NA所在行 sum(x,na.rm = T) #na.rm = T表示去除无效值 max(x) #最大值 min(x) #最小值 rowSums( y , na.rm=T ) #对行列求总和, 设置na.rm=T去除na值 colSums() rowMeans() #对行列求均值 colMeans() which.max(x) #返回向量最大值坐标 which.min(x) #返回向量最小值坐标 range(x) #最大最小值 mean(x) #平均数 var(x) #方差 sd(x) #标准差 median(x) #中位数 quantile(m.mad,na.rm = TRUE,probs=0.25) #四分位数 probs可以指定想要的百分位数 abs(x) #绝对值 sqrt(x) #取平方根 exp(x) #以e为底的指数 log(100,base=10) #直接还有log10(),log2()等 scale( ) #默认按照每列进行归一化